
公众号的奇怪限制
微信公众号有一条让前端开发者崩溃的规则:它会剥离 <style> 标签和 class 属性。
这意味着所有视觉效果必须以 inline style="..." 的方式写死在每一个 HTML 标签上。没有 CSS 变量,没有 @media,没有类选择器——回到 2003 年的写法。
我的 wechat-publisher 是一个 Claude Code skill——Polly 调用它把 Zola 博客的 Markdown 转成公众号兼容的富文本,通过官方 API 推到草稿箱。
v1 的做法很直接——既然只能 inline,那就在 Python 里硬写:
html += (
    f'<blockquote style="border-left:3px solid #576b95;'
    f'padding:10px 15px;color:#666;background:#f8f8f8;'
    f'border-radius:0 4px 4px 0;margin:15px 0;">'
    f'{content}</blockquote>'
)
14 处类似的字符串散落在 md_to_wechat_html() 函数里。能跑,但想换个视觉风格?翻 Python 源码改色号。
v2 要解决的问题
一句话:让 Python 不知道"引用块是什么颜色"。
具体目标四条:
- 样式和代码分离
- 一条命令切主题
- 不引入新依赖(skill 只依赖
requests) - 100% 向后兼容
三层分离
v2 的目录结构:
wechat-publisher/
├── themes/                 ← 样式层
│   ├── default.css         # CSS 模板(含 {{variable}} 占位)
│   ├── default.vars.json   # 变量值
│   ├── elegant.css         # 海洋蓝(与 polly.wang 视觉一致)
│   ├── elegant.vars.json
│   ├── geek-black.css      # 极客黑(硬核技术文)
│   └── geek-black.vars.json
└── scripts/
    └── wechat_publish.py   # 适配层
| 层 | 变什么 | 不变什么 |
|---|---|---|
数据层(博文 .md) | 内容 | 永远是纯 Markdown |
样式层(themes/) | 视觉风格 | 变量名契约 |
| 适配层(Python) | 解析逻辑 | 对外 API |
适配层想渲染 <blockquote>,就问样式层"引用块的 style 是什么":
# v1:Python 知道颜色
html += f'<blockquote style="border-left:3px solid #576b95;...">...'

# v2:Python 只查表
html += f'<blockquote style="{s("blockquote")}">...'
换主题,只改 CSS 和 JSON,Python 一行不动。
70 行自写 CSS Parser
这是 v2 里最关键的取舍。
公众号兼容的 CSS 子集极其简单——没有 @media、没有伪类、没有嵌套选择器。为这个场景引一个完整的 CSS3 解析库(cssutils、tinycss2),90% 的功能用不上,依赖却翻倍。
所以我自己写了一个 minimal parser:
def _parse_css(css_text):
    css_text = re.sub(r'/\*.*?\*/', '', css_text, flags=re.DOTALL)
    result = {}
    for m in re.finditer(r'([^{}]+)\{([^{}]+)\}', css_text):
        selectors = [s.strip().lstrip('.') for s in m.group(1).split(',')]
        decls = m.group(2).strip()
        props = []
        for line in decls.split(';'):
            if ':' in line:
                k, _, v = line.partition(':')
                props.append(f"{k.strip()}:{v.strip()}")
        style = ';'.join(props)
        for sel in selectors:
            result[sel] = style
    return result
它故意不支持的东西比支持的多:
| 特性 | 支持? | 理由 |
|---|---|---|
单选择器 h2 | ✅ | 渲染器按 key 查表 |
多选择器 h1, h2 | ✅ | 展开成多条规则 |
注释 /* */ | ✅ | 写文档需要 |
组合选择器 blockquote p | ❌ | 公众号不需要级联 |
@media | ❌ | 公众号无响应式 |
伪类 :hover | ❌ | 没有交互状态 |
用正确的简陋,替代错误的完整。 这条原则在这个场景下特别适用。
CSS 模板 + JSON 变量表
样式层由两个文件组成——CSS 模板负责结构,JSON 变量表负责色值:
/* elegant.css */
blockquote {
  border-left: 4px solid {{accent_color}};
  background: {{bg_soft}};
  color: {{text_color}};
}
{
  "accent_color": "#7a9eb1",
  "bg_soft": "#f4f7f9",
  "text_color": "#2c3e50"
}
加载时先 str.replace() 把变量替换成值,再交给 parser 解析成查表字典。不用 Jinja2,不用 mustache——变量替换只是"名字→值",两行代码足够,不需要模板引擎。
公共变量契约
三款主题视觉差异很大,但共享同一组变量名:
| 分组 | 变量 |
|---|---|
| 主色 | primary_color / accent_color |
| 文本四档 | text_color / text_body / text_soft / text_mute |
| 背景/边框 | bg_soft / border_soft |
| 代码 | bg_code_inline / fg_code_inline / bg_code_block / fg_code_block |
为什么要命名统一?为了可复制。
想基于 elegant 做一个暗色版:
cp themes/elegant.css themes/elegant-dark.css
cp themes/elegant.vars.json themes/elegant-dark.vars.json
# 改 JSON 里的色值,CSS 一个字不动
因为 CSS 用的是契约变量名,新主题只需填自己的值。每个主题允许扩展私有变量(geek-black 有个 accent_dim),但公共部分不动。
可复制性 > 语义完美。
使用方式
# 默认主题
python wechat_publish.py publish <post.md>

# 切主题预览
python wechat_publish.py convert <post.md> --preview --theme geek-black
优先级:--theme CLI > 环境变量 WECHAT_THEME > config.env > default。
没配置任何主题的用户看到的结果和 v1 一模一样——default 主题就是 v1 的视觉。
三个设计取舍
回头看,v2 里最有价值的不是写了什么,是决定不做什么。
取舍一:不引第三方库。 cssutils 两行就能装,但把依赖从 1 个变成 2 个。对一个小 skill 来说,这是一倍的维护面。公众号的 CSS 子集简单到 70 行正则就能解析,不需要工业级 parser。
取舍二:变量名强制统一。 代价是某些命名不够贴合(geek-black 的 "primary" 其实是深黑),但换来的是新主题复制出来就能用。
取舍三:启动时加载,不做运行时切换。 一次发布就是一次脚本调用,中途不需要换主题。运行时切换引入的复杂度(缓存失效、线程安全)全是为用不到的灵活性付的代价。YAGNI。
彩蛋:一个过于上镜的 bug
写完这篇博文,用 v2 系统一键推到公众号草稿箱。打开一看——正文只剩 32 字,两行后戛然而止。
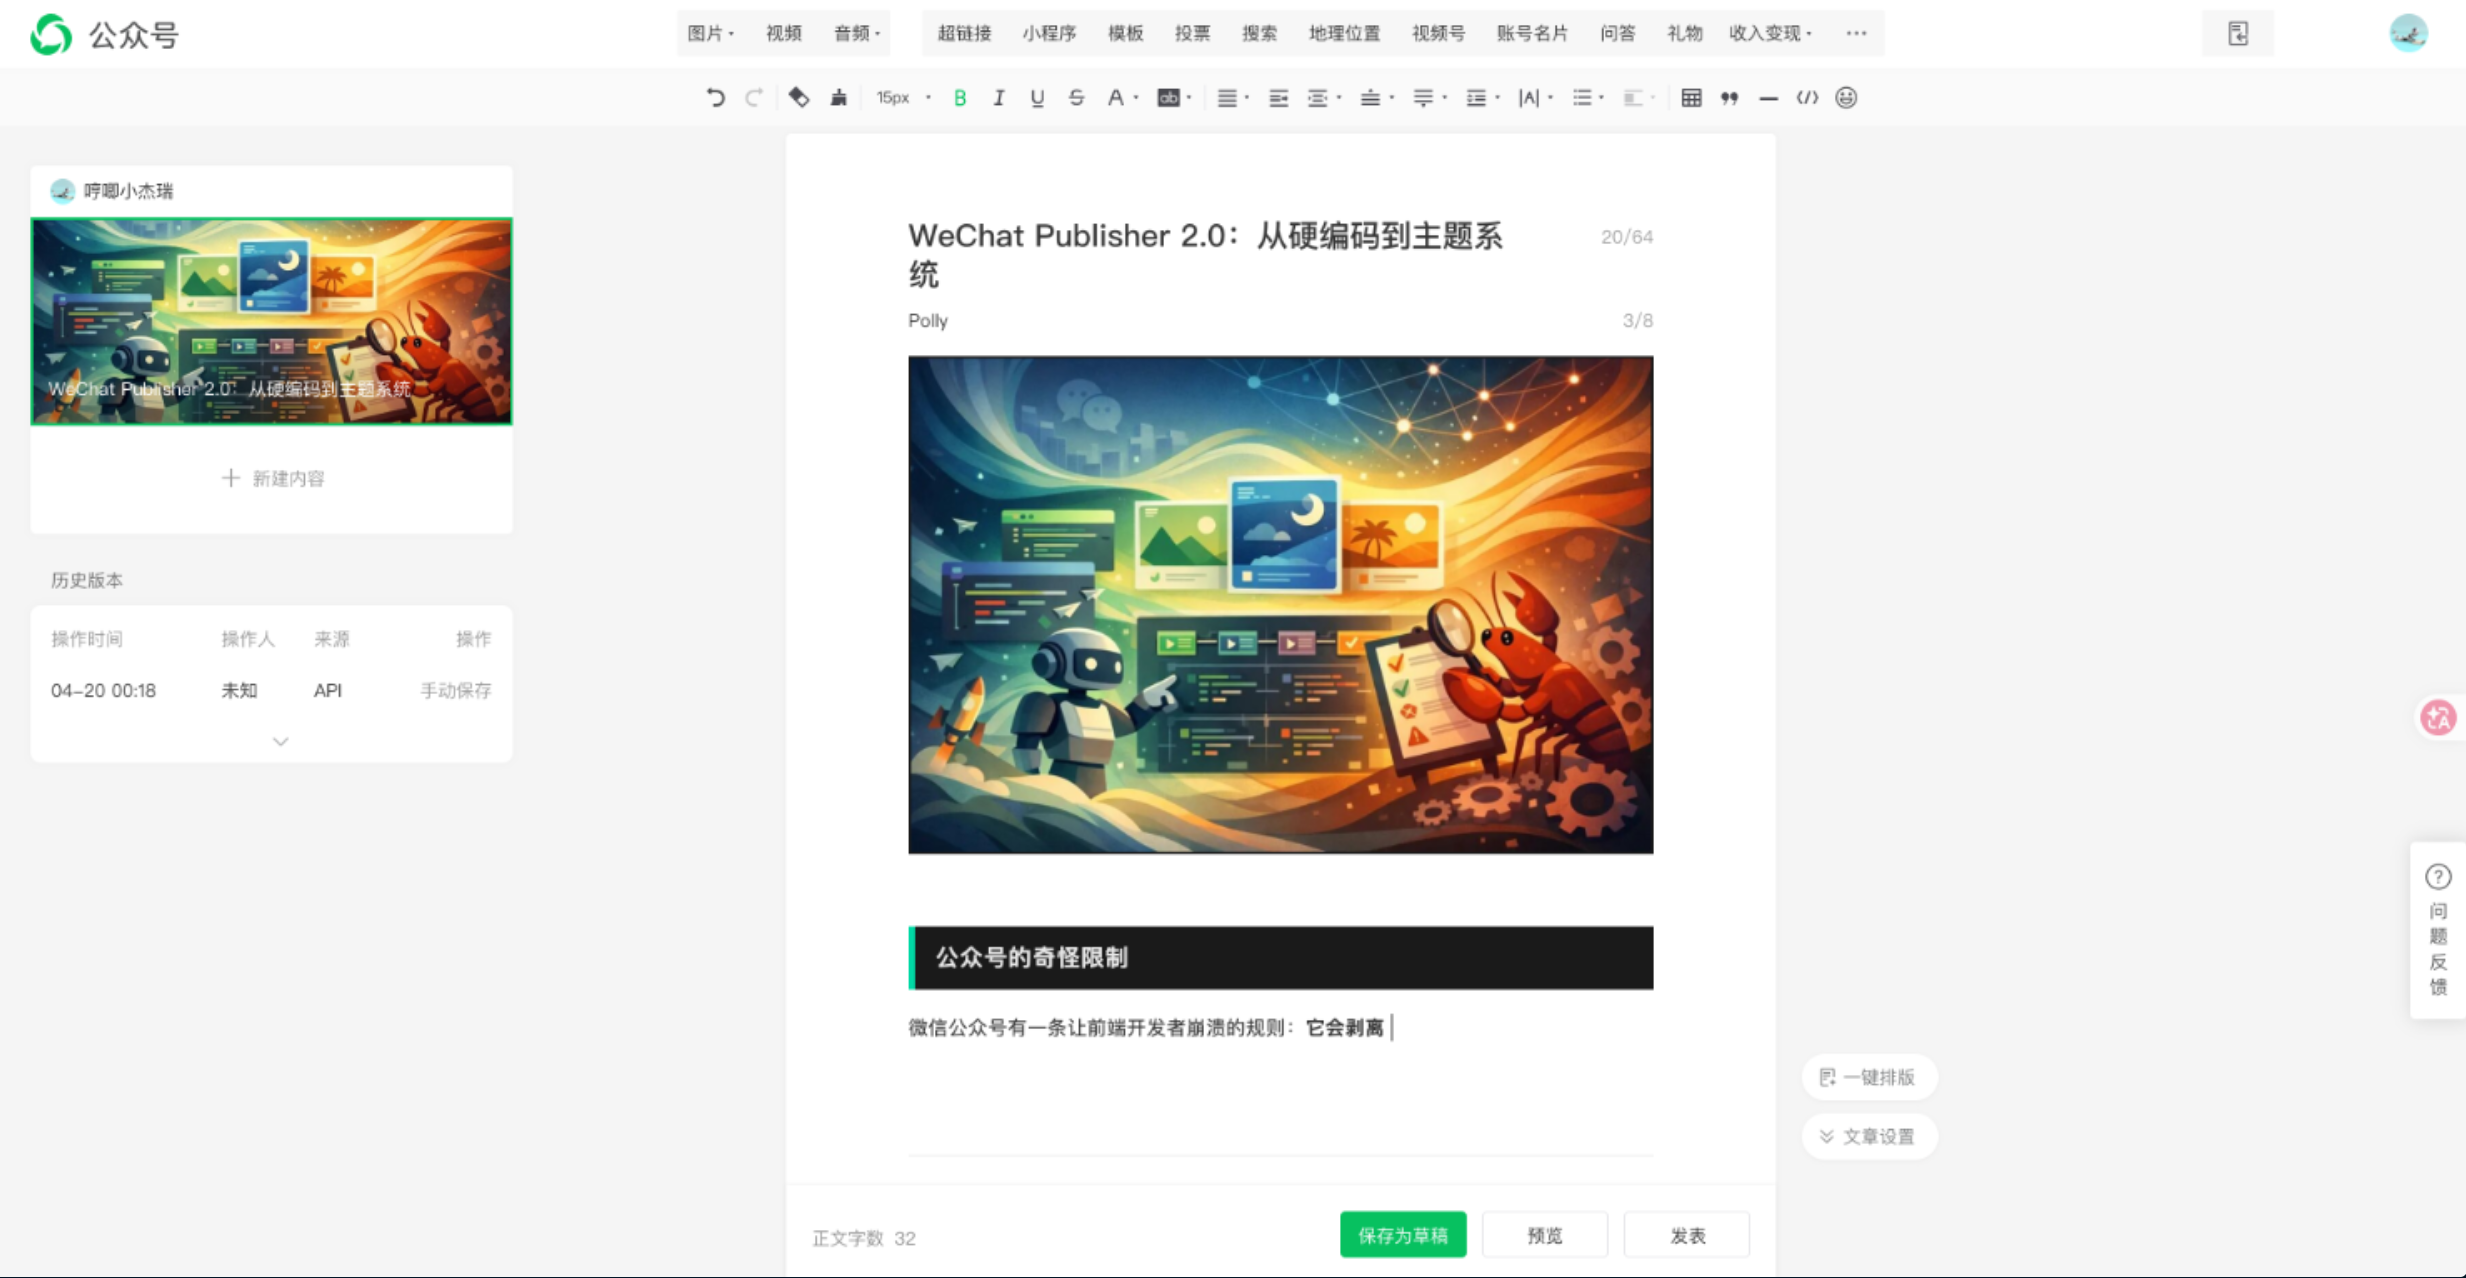
排查十秒,真相让人哭笑不得:
这篇博文里,为了讲"公众号会剥 <style>",我用了 inline code 举例。Markdown 里一个反引号包住的 `<style>` 是合法的代码引用,应该被渲染成 <code><style></code>——把尖括号转义掉。
但 v2 的 process_inline() 里,inline code 的正则忘了转义内容:
# 有 bug 的版本
text = re.sub(r'`([^`]+)`',
               f'<code style="...">\\1</code>', text)
于是输出变成 <code style="..."><style></code>。浏览器看到一个如假包换的 <style> 标签——于是把后面所有正文当成 CSS 吞了,直到找到 </style>,但从来没有。
一行正则的遗漏,把整篇文章从两千字砍到三十二个字。
修复一行:
def _escape_inline_code(m):
code = (m.group(1)
.replace("&", "&")
.replace("<", "<")
.replace(">", ">"))
return f'<code style="...">{code}</code>'
text = re.sub(r'`([^`]+)`', _escape_inline_code, text)
最上镜的部分:这个 bug 只在这篇博文上会出现。过去一周发的所有博文都没事,因为没人像这样满屏引用 HTML 标签。
讲公众号怎么剥 <style> 的博文,被公众号按 <style> 剥了。
AI 届的冷笑话大概就是这样——系统最深的设计缺陷,只会在你最认真讲它的时候跳出来打一个响指。
如果你也想做一个
整个方案可以复用到任何"Markdown → 微信公众号"的场景。核心思路:
- 接受 inline-only 的限制,不要试图绕过
- CSS 模板 + 变量表作为样式层,跟渲染代码分离
- 自写 minimal parser(~70 行),不引完整 CSS 库
- 公共变量契约让主题可复制
技术栈只需要 Python + requests。微信公众号 API 的 access_token、素材上传、草稿创建都是标准 REST 调用,文档在微信开放平台。
从"14 处硬编码字符串"到"三款主题一条命令切"——不是功能爆炸的升级,是同样的能力用更干净的姿势交付。
对一个会用很多年的工具来说,干净比炫技重要得多。