盯着终端里一行行刷过去的日志,脑子里只有一个念头:
我知道它在跑,但我不知道它现在到底跑到了哪里。
批量翻译的旧体验,就是一堵会滚动的文字墙。每个 chunk 最终完成时你能看到,但在进行中,三件关键事情一眼判断不了:
- 整体进度是不是健康
- 哪几个块在卡住
- 当前吞吐到底是快还是慢
当规模从几块变成几十块、再到多语言并行的几百次调用时,这三件事不清楚,焦虑指数级上升。
目标很朴素:做成像 top 那样,一眼可读。
改了什么
核心思路:把"事件日志"变成"状态面板"。
三层显示策略,确保任何环境都能跑:
auto:检测终端与依赖,能上面板就上rich:强制面板plain:回退到传统日志
体验升级不绑架可用性——终端条件不好时自动降级,不影响翻译主流程。
面板分两层:
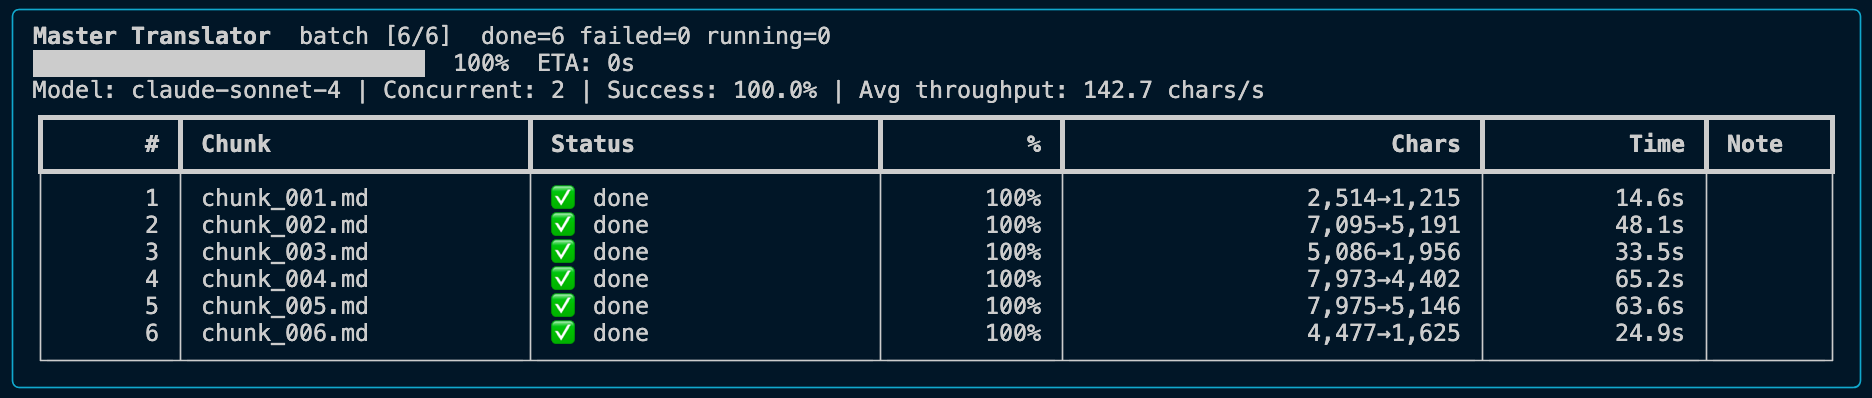
上层——全局态势:
- 总进度条 + ETA
- 成功率
- 瞬时吞吐(近 5s chars/s)与平均吞吐(全程 chars/s)
下层——逐块状态:
- chunk 编号 + 状态(pending / running / retry / done / failed)
- 百分比 + 实时字符数
- 耗时 + 重试备注
两个吞吐并排是我最满意的细节。平均值告诉你全程表现,瞬时值告诉你此刻体感——只看一个,要么忽略突发抖动,要么被短期波动误导。两者并排,才是可操作的信息。
真正值钱的不是界面
表面看是终端好看了。实际是工程行为变了。
以前等任务跑完,再回头看哪里慢、哪里失败。现在运行中就能做判断:
- 某块长期低百分比——模型慢还是网络慢?
- 某批吞吐突然下滑——系统波动还是内容复杂度上升?
- 成功率变化——偶发失败还是配置问题?
"排障"变成了"调度"。从被动监工到主动驾驶。
用实验书稿重跑了一遍全流程验证:6 chunk 全部成功,面板实时可读,每块百分比让"哪里慢"一眼可见。这类反馈在小任务里是锦上添花,在 24 chunk × 10 语言的规模里就是救命信息。
一句话
当系统进入规模化阶段,界面不是装饰,它是控制面。
而且这次,我终于能在终端里看到它"呼吸"了。