
接上回:观潮验证记——首批信号回填,5 天胜率 76.9%。
那篇的结论是:信号系统跑通了,数据说话,观潮不是随手一写的玩具。但有个问题一直搁着没动——它只看 A 股。
"能看 TSLA 吗?"
这个问题的答案,在今天之前是"不能"。
观潮的数据层建立在 baostock(A 股日 K 线)和 AKShare(资金流向、新闻、龙虎榜、北向资金)之上。这两个数据源提供了丰富的 A 股生态数据,但也把观潮牢牢钉在了 A 股的地盘上。
我一直在想:一个投研引擎如果只能看一个市场,那它的视野就永远有天花板。美股不只是"另一个市场",它是全球科技股定价的锚。AAPL、TSLA、MSFT——这些名字每天都在影响 A 股的半导体、新能源、云计算板块。
所以今天的任务很明确:让观潮出海。
一个函数决定两个市场
设计的第一个问题:怎么区分 A 股和美股?
A 股代码是纯数字(002111、600519),美股代码是字母(AAPL、TSLA)。这意味着只需要一个判断:
def is_us_stock(symbol: str) -> bool:
    """首字母是字母就是美股"""
    return bool(symbol) and symbol[0].isalpha()
三行代码,但它贯穿了整个架构——从数据拉取、体制识别、叙事生成、LLM 润色到行为护栏,所有模块都用这一个函数做路由分发。
数据源选择上,我用了 yfinance——免费、零反爬、覆盖全球市场。实测 AAPL 的 120 天 K 线拉取只要 0.2 秒,比 baostock 的 0.28 秒还快。而且不需要像 AKShare 那样担心东方财富的反爬机制。
路由设计很直接:
def get_stock_daily(self, symbol, days=120, adjust="qfq"):
    if is_us_stock(symbol):
        return self.get_us_stock_daily(symbol, days)  # yfinance
    # A 股走 baostock...
get_stock_name()、get_index_daily() 同理——一个 if 分发两个市场,该走 yfinance 走 yfinance,该走 baostock 走 baostock。
八个文件的连锁反应
看起来只是"加个数据源",但实际改动波及了 8 个文件、180 行代码。因为"看美股"不只是拉 K 线那么简单——整个分析链路都需要市场感知。
数据层:不只是拉数据
data.py 是改动最大的文件。除了 yfinance K 线接入,还有两个关键设计:
名称缓存。yf.Ticker("AAPL").info 会触发一次完整的 HTTP 请求拿全量公司信息,只为取一个名字。在 scan_market 的循环扫描中,每只美股都调一次就太慢了。解决方案是加一个类级别的内存缓存:
_us_name_cache: dict[str, str] = {}

def get_us_stock_name(self, symbol: str) -> str:
    if symbol in self._us_name_cache:
        return self._us_name_cache[symbol]
    # 首次调用才走 HTTP,之后都从缓存读
yfinance 参数选择。最初用 period="240d" 拉数据,但 yfinance 最大只支持 "730d"。如果 days=365,days*2=730 刚好踩线,再大就报错。改用 start 参数更精确:
start = (datetime.now() - timedelta(days=days * 2)).strftime("%Y-%m-%d")
df = ticker.history(start=start)
引擎层:SPY 替代上证指数
server.py 的核心改动在 _analyze_stock_sync()——这是观潮的主分析函数。
A 股分析时,市场体制用上证指数(000001)做基准。美股显然不能用上证——SPY(标普 500 ETF)是更合适的锚:
index_code = "SPY" if _is_us else "000001"
同时,A 股独有的资金流向(主力资金净流入/流出)、新闻(AKShare 爬取东方财富)、北向资金——这些在美股世界里不存在。解决方案是 graceful fallback:
_skip_money = _is_us or is_etf or not include_money_flow
_skip_news = _is_us or is_etf or not include_news
不报错、不崩溃,只是返回空数据。
scan_market 也需要适配——如果持仓或自选里有美股,扫描时的体制调整必须分市场计算。A 股用上证的 regime bias,美股用 SPY 的 regime bias:
_regime_biases = {}
for market_key, idx_code in [("A", "000001"), ("US", "SPY")]:
    idx_df = market_data.get_index_daily(idx_code, days=120)
    r = regime_detector.detect(idx_df)
    _regime_biases[market_key] = regime_detector.get_regime_adjustment(r["regime"])["signal_bias"]
分析层:SPY 相对强弱替代资金面
美股没有资金流向数据,叙事报告会"少一段"——显得比 A 股分析薄。
我用 SPY 相对强弱来填补这个空缺。在 server.py 里计算好数据,通过 money["_us_relative"] 传递给 narrative.py 消费:
# server.py: 计算 SPY 相对强弱
spy_pct_5d = (float(index_df.iloc[-1]["close"]) / float(index_df.iloc[-5]["close"]) - 1) * 100
money["_us_relative"] = {
    "spy_pct_5d": round(spy_pct_5d, 2),
    "relative": round(stock_pct_5d - spy_pct_5d, 2),
}
# narrative.py: 三种情况的叙事化
if abs(rel) < 1:
    context_parts.append(f"近5日与SPY走势同步(SPY {spy_pct:+.1f}%)")
elif rel > 0:
    context_parts.append(f"近5日跑赢SPY {rel:.1f}个百分点,相对强势")
else:
    context_parts.append(f"近5日跑输SPY {abs(rel):.1f}个百分点,相对弱势")
这样 TSLA 的叙事就变成了:"近5日跑输SPY 3.3个百分点(SPY -0.4%),相对弱势"——比"无资金面数据"有价值得多。
润色层与护栏:市场角色切换
LLM 叙事润色的 prompt 也做了市场感知。A 股用"A股分析师"的人设和规则(1手=100股),美股用"美股分析师"(支持碎股交易):
if is_us:
    market_role = "美股分析师"
    market_rules = "- 美股支持碎股交易,无最小交易单位限制"
else:
    market_role = "A股分析师"
    market_rules = '- A股交易规则:最小交易单位1手=100股...'
行为护栏的追高检测也需要调整——美股没有涨跌停限制,波动比 A 股大得多。5 日涨 8% 在 A 股算追高,在美股很常见。阈值从 8% 提高到 15%:
threshold = 15 if is_us_stock(symbol) else 8
还有一个容易忽略的细节:我的账户资金都是人民币。美股分析如果告诉 LLM"你还有 1.2 万可用",它会按美元理解,给出完全错误的仓位建议。所以美股分析时直接跳过账户资金上下文。
前端:三件套搞定币种适配
Dashboard 的改动集中在三个工具函数上:
function isUSCode(code) { return code && /^[A-Za-z]/.test(code); }
function cur(code) { return isUSCode(code) ? '$' : '¥'; }
function displayName(s) {
  if (isUSCode(s.code)) return s.code;  // MSFT 做主标题
  return s.name || s.code;              // 比亚迪 做主标题
}
A 股习惯用公司简称("比亚迪"),美股习惯用 ticker("MSFT")。如果用全名"Microsoft Corporation"做卡片标题,会占两行,跟 A 股的四字简称格格不入。
顶部摘要栏也做了智能标注——检测持仓组成,纯 A 股显示"持仓总浮盈(¥)",纯美股显示"持仓总浮盈($)",混合则显示"持仓总浮盈(混合币种)"。
三轮代码审查:从 7.5 到 9.5
代码写完不算完。我让"小龙虾"(AI Code Reviewer)做了三轮审查,这个过程本身比写代码更有收获。
第一轮:7.5/10,三个 P0
小龙虾看完全部代码后给了 7.5 分——"骨架搭得不错,路由设计干净,但有几个问题上线会踩坑":
- P0-1:
scan_market的体制识别写死了上证指数"000001"。如果自选里加了美股,扫描时会用 A 股的体制做评分调整——这是错的。 - P0-2:
get_us_stock_name每次调用都走 HTTP 请求,在扫描循环里会很慢。 - P0-3:如果有人
analyze_stock("SPY"),regime 会用 SPY 跟自己比——等于没有 market context。
还有 5 个 P1(guardrails 阈值、narrator 少一段、tracker 交易日对齐、manage_account 币种、compare_stocks 跨市场说明)和 2 个 nit(yfinance period 上限、CLAUDE.md Dashboard 状态不准)。
全修后 Re-Review:9/10
10 项全部修完后,小龙虾重新看了一遍:
9/10 — 10 项全部修复,质量扎实。特别点名表扬 P1-5 的 SPY 相对强弱实现——不是简单加句话,而是 server 算数据 → money dict 传递 → narrative 消费的完整链路,这是正确的工程做法。
被点名表扬的那个设计,核心思路是职责分离:数据计算在 server.py(它有 index_df),通过 money["_us_relative"] 传递给 narrative.py(它只管生成文本),不让叙事层自己去拉数据。
Dashboard 适配 Re-Review:9.5/10
前端适配也过了一轮审查。扣的 0.5 分很实在:"混合币种摘要把人民币和美元的浮盈直接加在一起了"——但因为我目前只在 A 股有持仓,美股只做观察不买入,这个问题不阻塞。
代码审查的价值
三轮 review 教会我一件事:自己写的代码里,最危险的 bug 不是你不会,而是你看不到。
scan_market 写死上证指数——我知道应该区分市场,但在两处不同的扫描函数里各复制了一份 "000001",就是忘了改。名称缓存——我知道 .info 慢,但"就几只美股,能慢到哪去"的想法让我跳过了它。
这些不是能力问题,是注意力盲区。有个 reviewer 帮你盯着,值。
效果:MSFT $389.02,看空 -55
最终效果是这样的——点开 MSFT 的详情面板:
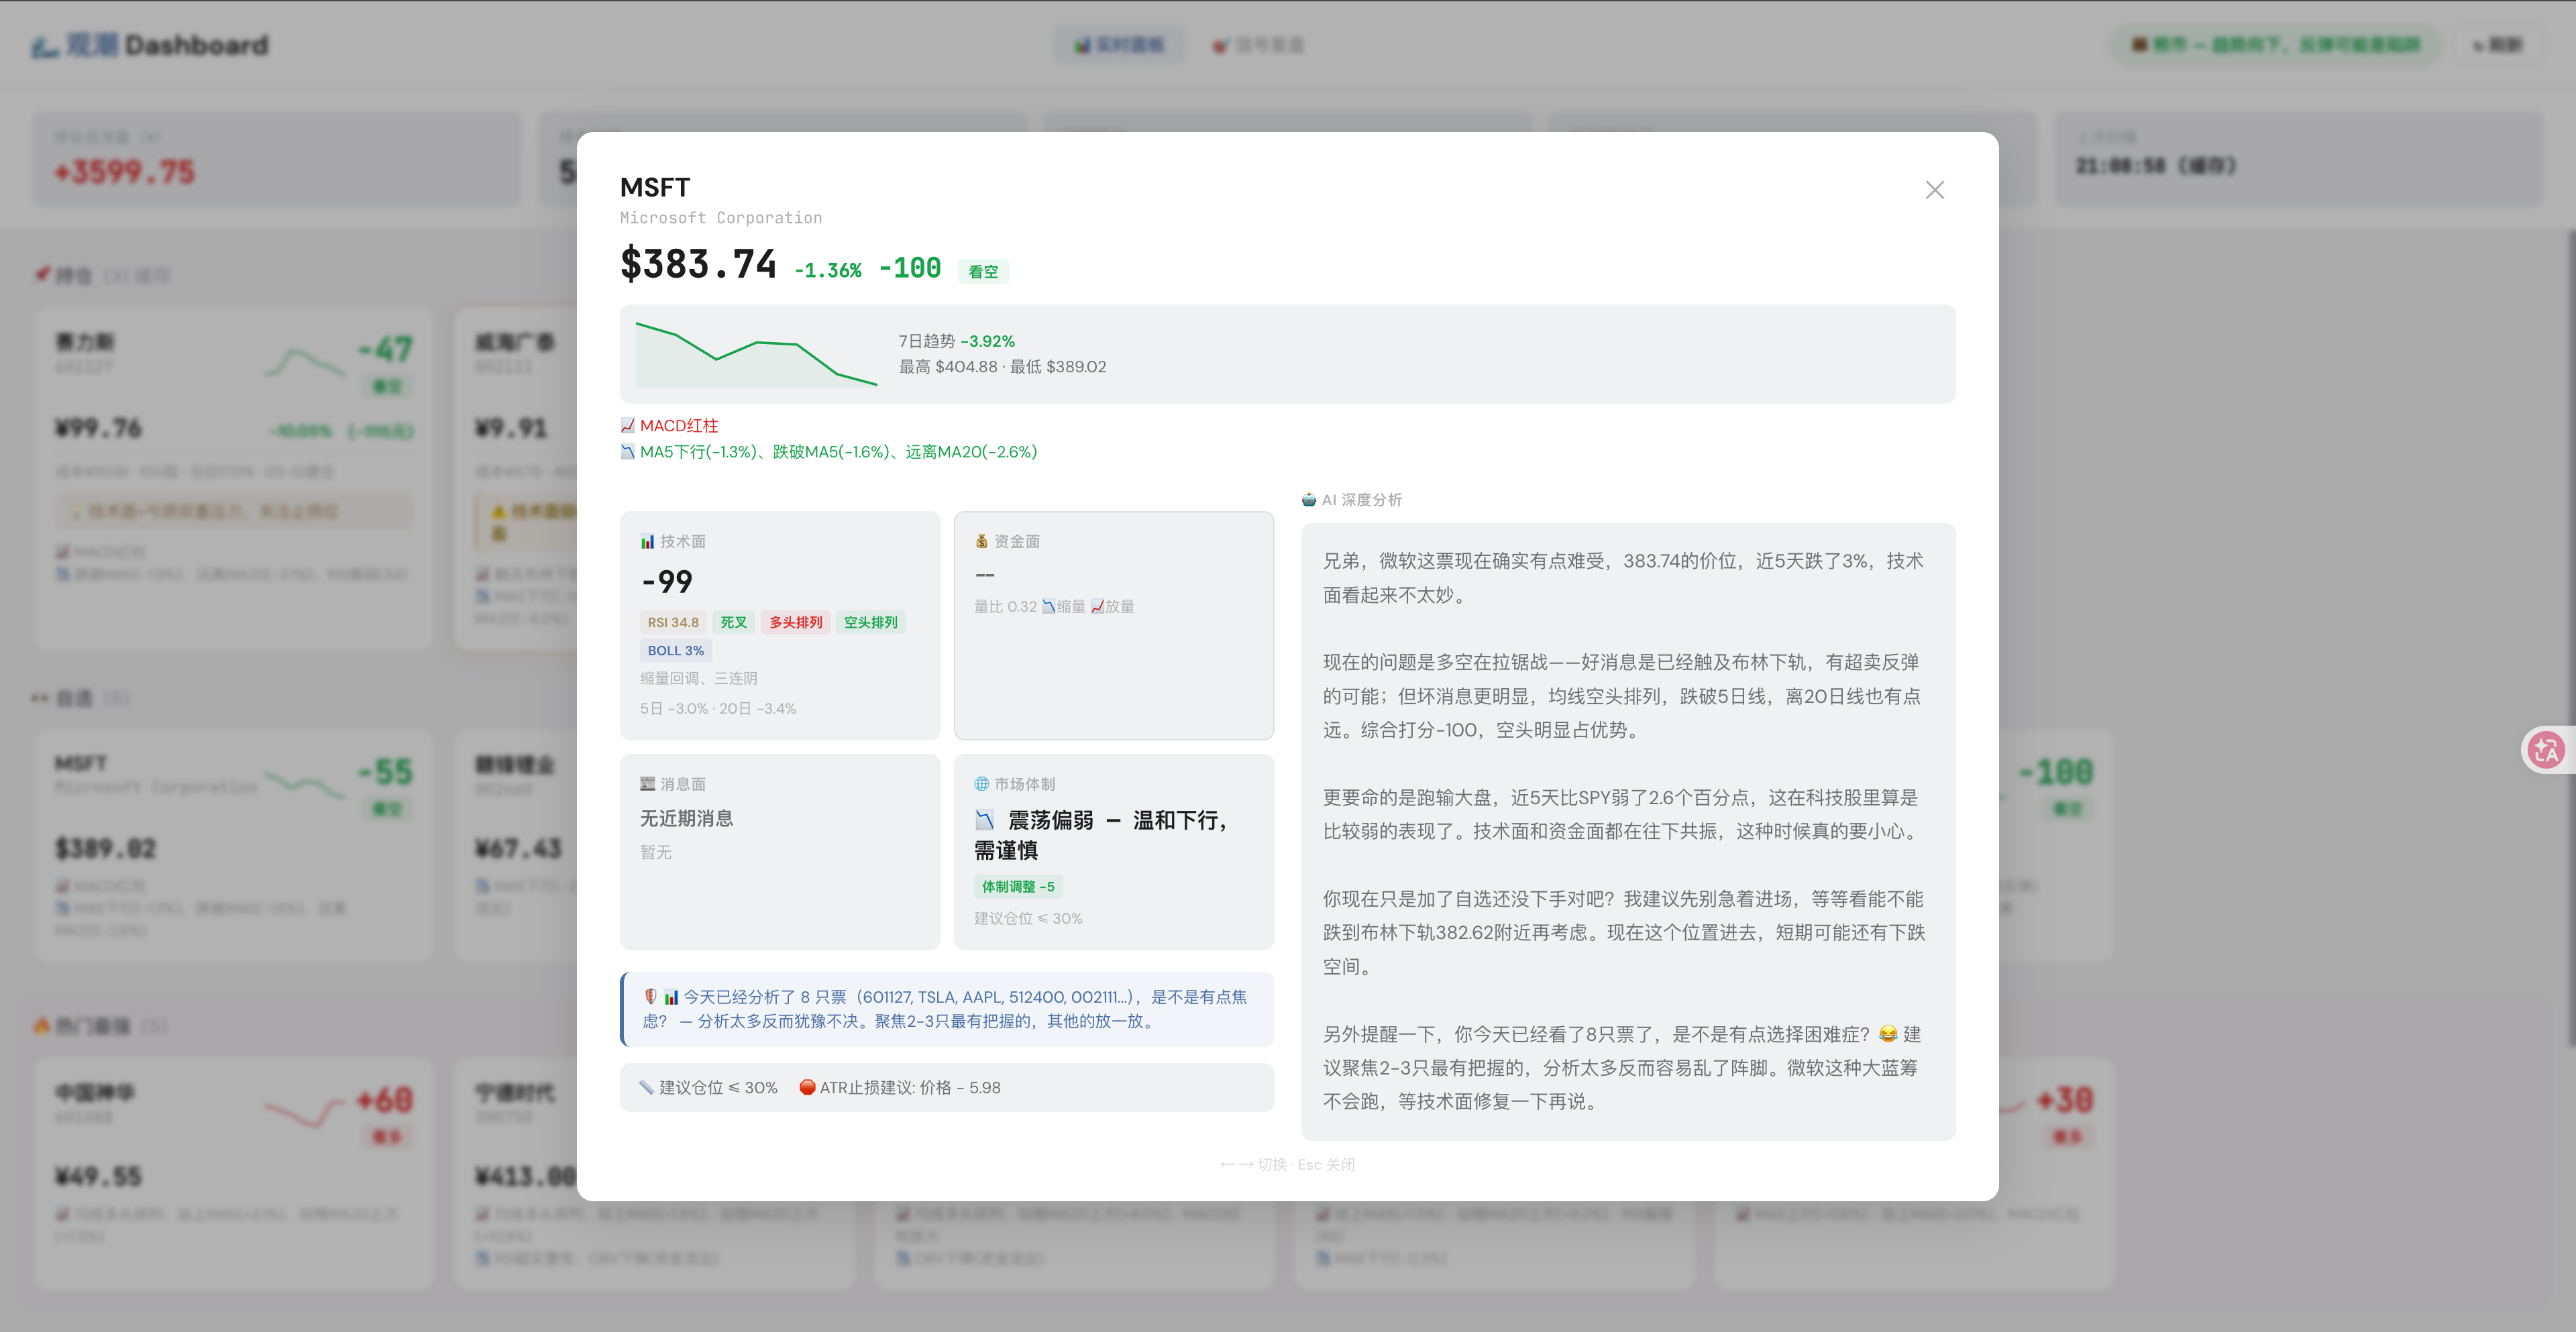
- 主标题是 ticker「MSFT」,不是冗长的"Microsoft Corporation"
- 价格前面是
$而不是¥ - 市场体制用 SPY 识别为"震荡偏弱"
- AI 深度分析用"美股分析师"视角,没有出现人民币、1手100股这些 A 股概念
- SPY 相对强弱替代了资金面段落:"跑输大盘快3个点了"
整个分析从发起请求到 LLM 润色完成,大约 3 秒。其中 yfinance 拉数据 0.2 秒,技术分析 0.01 秒,LLM 润色约 2.5 秒。
观潮出海了
回看今天的改动——8 个文件、180 行代码、6 个 commit、三轮代码审查。不多,但每一行都在回答同一个问题:一个投研引擎怎么做到"市场感知"?
不是简单地换个数据源。是体制识别要换锚(SPY vs 上证),叙事要补段(相对强弱 vs 资金流),护栏要调阈值(15% vs 8%),LLM 要切角色(美股分析师 vs A股分析师),前端要适配币种($ vs ¥),账户上下文要知道什么该说什么不该说(人民币账户对美股没有参考价值)。
这些细节单独看都不难,但它们加在一起就构成了「市场感知」这个概念。一个真正理解市场的引擎,不是什么数据都往里塞,而是知道哪些信息在当前上下文里有意义。
下一步:回测引擎 v1——用历史数据验证观潮的信号策略能不能跑赢沪深 300。信号验证的 76.9% 胜率是在少量样本上的,要真正有说服力,得跑回测。
观潮系列:诞生记 → 云端部署 → Dashboard + 信号 → 信号验证 → 出海记