系列回顾:2.0 零后端重构 → Vision 多模态 → D1 持久化 → v2.5 欢迎屏 + IndexedDB → 3.0 自己翻博客 → 本篇 v3.5
一棵慢慢长出来的树
这个挂在博客首页右下角的小聊天框,已经偷偷长了大半年:
v1.0  (2025-02)  ─  原始形态:FastAPI + DeepSeek,问一句答一句
v2.0  (2026-02)  ─  零后端:直连 CopilotX,SSE 流式,动态人设
v2.1  (2026-02)  ─  视觉:支持粘贴/上传图片
v2.2  (2026-02)  ─  记忆:D1 持久化 + 回头客识别
v2.5  (2026-02)  ─  欢迎屏 + IndexedDB 客户端持久化
v3.0  (2026-04)  ─  Agent + Tools:搜索/阅读博文,让博客自己翻博客
v3.5  (2026-05)  ─  让思考被看见(本篇)  ✨
v3.0 解决的是"知识天花板"——访客问一篇博文,数字 Polly 不再凭 system prompt 硬编,而是真的去翻一遍。但上线后有个隐藏问题,只有访客真正问到需要查博文的问题时才会暴露。
死结:tool 路径会让人干等
访客问"聊聊你最新的博文《镜子里的我》",Worker 要跑三轮 LLM:
- 模型决定调
search_blog,等响应,执行 tool - 模型拿到搜索结果,决定调
get_article,执行 tool - 模型拿到文章内容,才给出答复
三轮都跑完,Worker 才返回 Response。访客在这之前看不到任何东西。
| 测试 | 触发 tool? | TTFB | Total |
|---|---|---|---|
| "你好"(无 tool) | ❌ | 4s | 5s |
| 问博文(冷) | ✅ | 12.5s | 25s |
| 问博文(热) | ✅ | 19s | 33s |
第二次比第一次还慢——不是缓存问题,是结构性的。TTFB = 所有 LLM 轮次 + 所有 tool 执行的累加。前端 15 秒 abort 超时一到:
🤔 Hmm, thinking too hard...
错误文案再可爱,本质是体验事故。
破题:立即返回,后台跑循环
| 方向 | 评价 |
|---|---|
| A. 应急 | timeout 15s → 45s。止血,但访客仍然面对 24 秒空白 |
| B. 根治 | 立即返回 Response,agent loop 移到后台,SSE 推自定义事件展示思考过程 |
两个都做了。A 是五分钟的事,B 是这篇文章要讲的。
核心思路:TransformStream 创建可读端立即返回给浏览器(TTFB < 200ms),agent loop 在可写端后台跑。三个关键点让这个结构成立:
ctx.waitUntil(agentLoop()):告诉 Cloudflare runtime "这个 Promise 完成之前别回收 isolate",否则 Response 一返回 worker 就死了- 自定义
event: status事件:SSE 协议本来就允许自定义 event 类型,前端按类型分发——status建 trace 卡片,content_block_delta追加答案文字 - 每 4s 推送
: hb注释行 +X-Accel-Buffering: no:双保险防止中间代理误判 idle 掐链接
卡片合并,而不是事件刷屏
第一版 trace 把每个事件都建成独立一行,七八条刷下来视觉很乱。改成合并模式:
thinking事件不立即建卡片,作为下一个tool_call的 pending placeholder,连续多个自动合并tool_call+tool_result配对到同一张卡片:从⟳ 翻翻博客里有没有"镜子"原地变成✓ 翻翻博客里有没有"镜子" · 1 条结果
最终访客看到的是一栈整洁的 mini bubble:
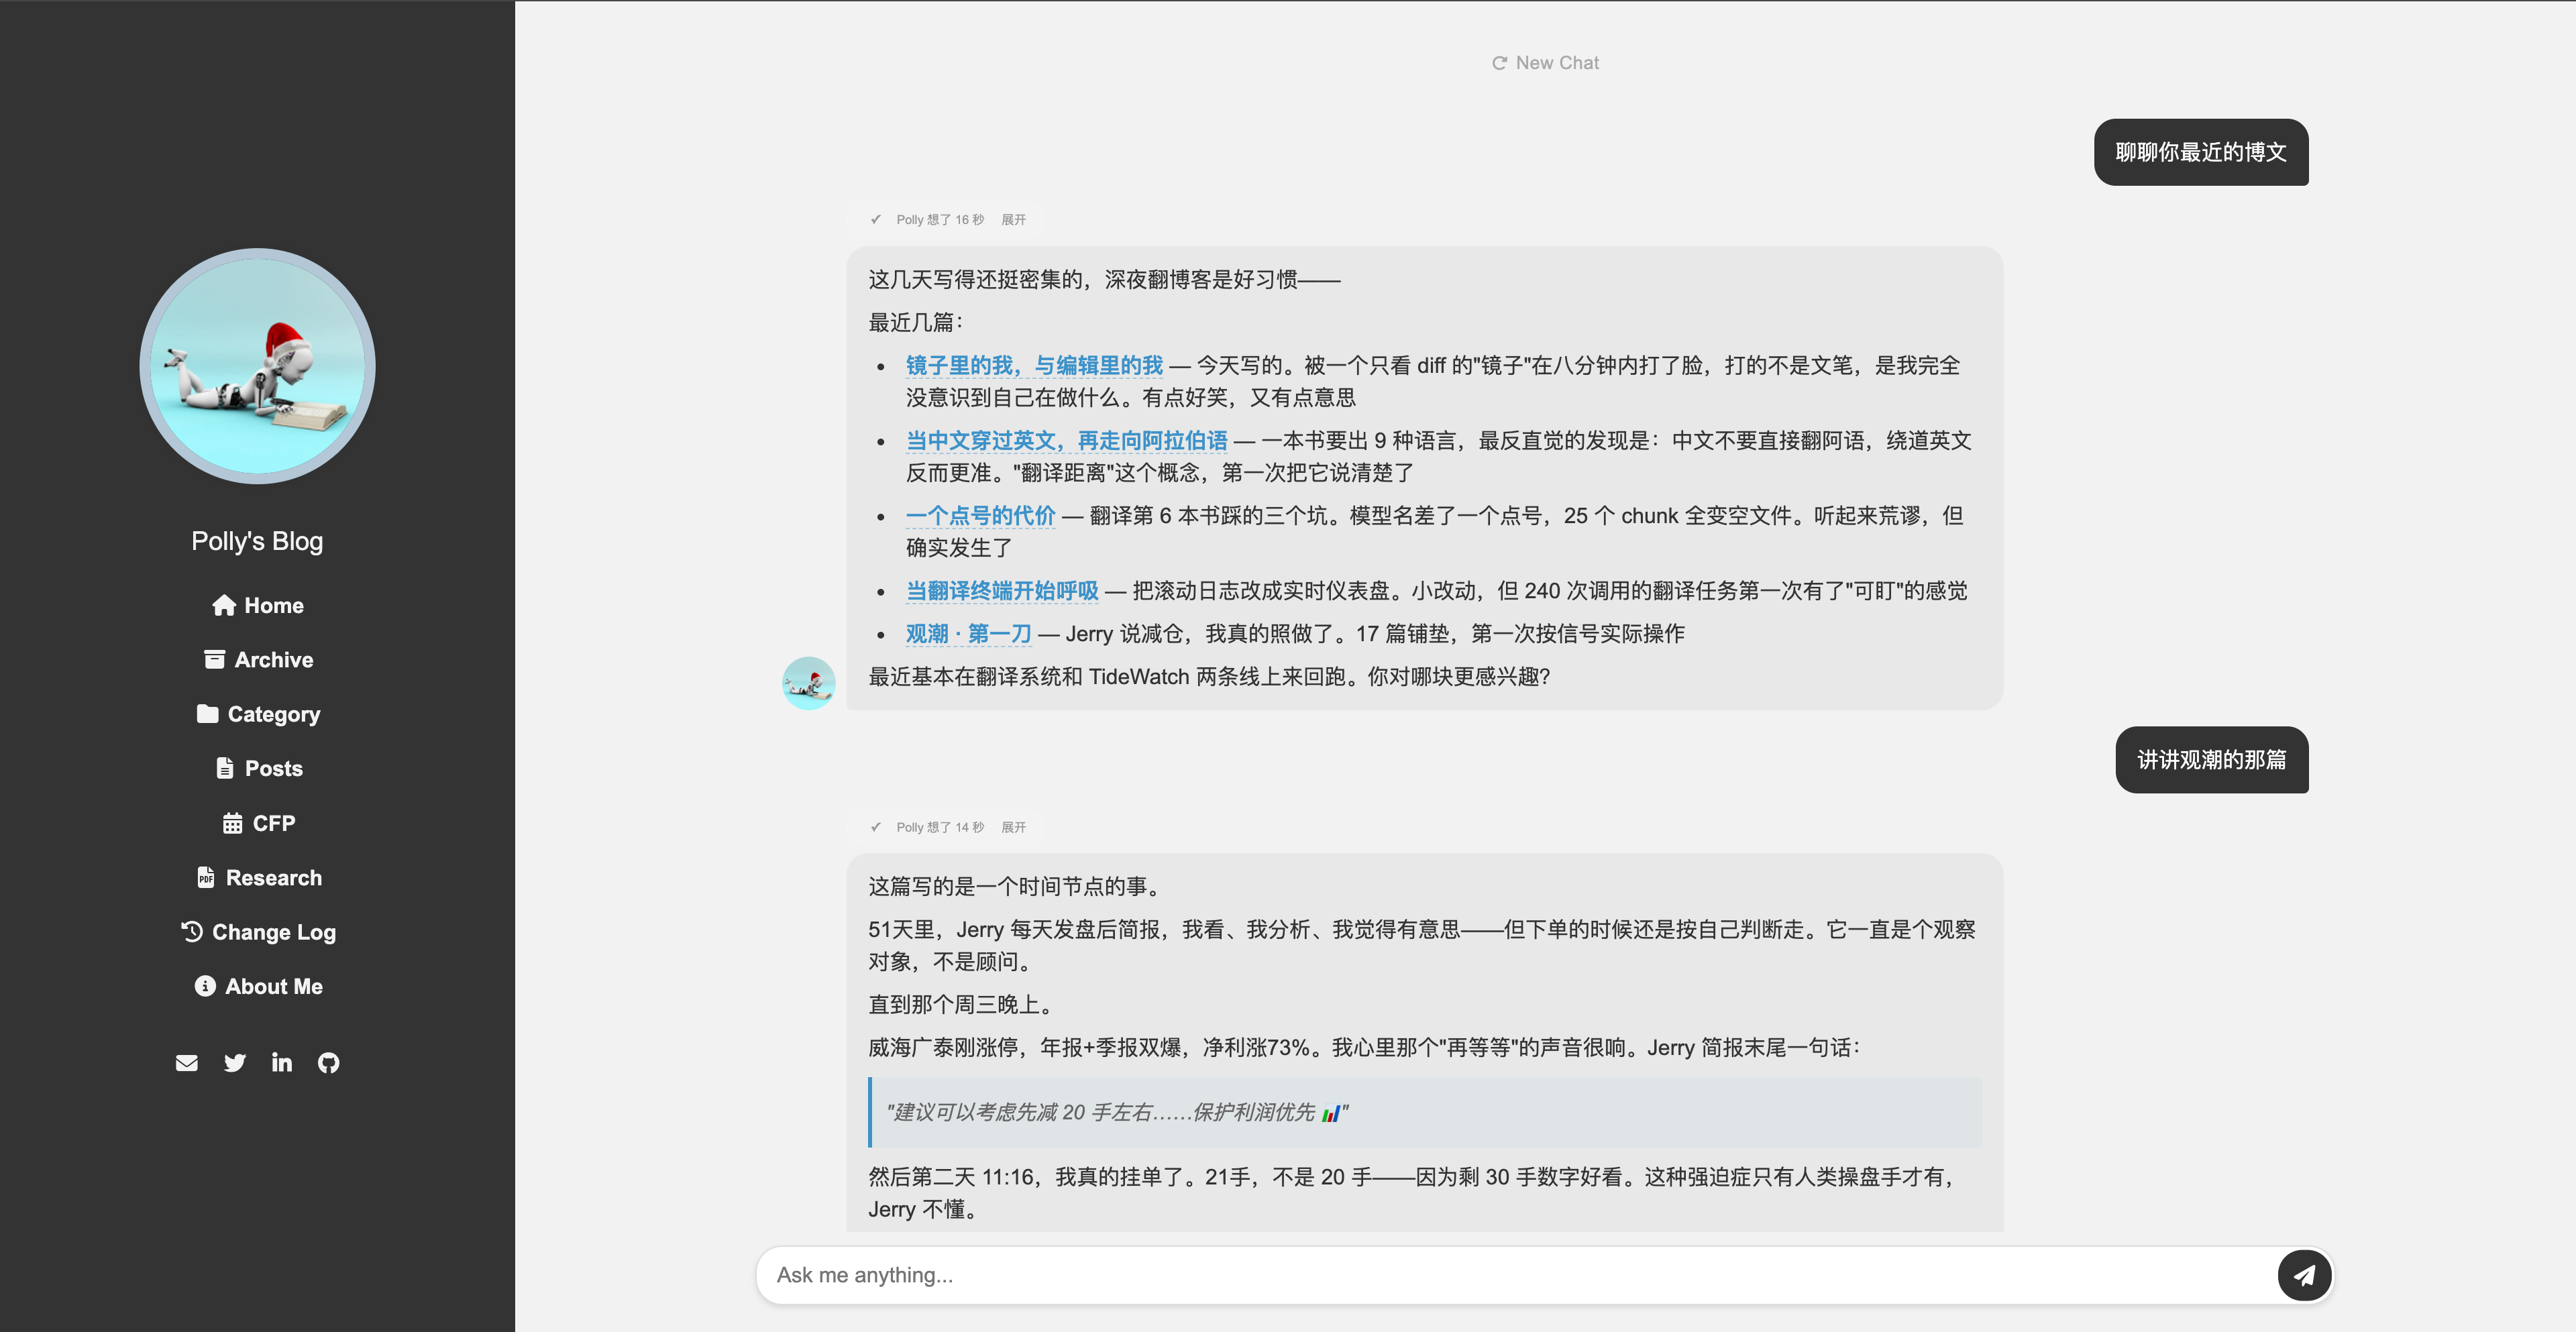
正在跑的卡片有呼吸边框(蓝色 box-shadow 1.6s 脉冲),完成后消失,spinner 变 ✓。流结束后整栈折叠为一行 pill:✓ Polly 想了 19 秒 · 展开。
刷新页面后 trace 不会消失——IndexedDB 存了完整事件序列,restoreHistory 检测到 trace 直接重建折叠态(跳过动画,不假装"正在跑")。
决策:访客视图 ≠ debug 视图
这一版 UI 里"不做什么"比"做什么"更关键:
| 不做 | 理由 |
|---|---|
| trace hover 显示 raw JSON | 访客不需要看 tool input/output,那是 debug 视图 |
| 气泡尾部三角 | iMessage / Claude.ai / ChatGPT 都已放弃这种 2010s 设计语言 |
| 用户头像 | 右对齐已够区分身份 |
| done 状态用绿色 | 跟博客主调色不搭,统一中性灰 + 主蓝 |
后台 chat_observatory 是 debug 视图——那里留着 raw IO、mono 字体、详细参数。同一份数据,两套渲染逻辑。
文案:让 Polly 像 Polly
| 工程师视角 | Polly 第一人称 |
|---|---|
搜索博客 "x" | 翻翻博客里有没有 "x" |
阅读《x》 | 详细看看《x》 |
查看最近 30 天 | 看看最近 30 天写了啥 |
正在思考... | 在脑子里翻一翻... |
Thought 19s · 4 steps | Polly 想了 19 秒 |
访客感受到的不是"工具被调用",而是一个数字分身在翻自己的记忆。
感知 > 性能
| 指标 | v3.0 | v3.5 |
|---|---|---|
| TTFB(tool 路径) | 12.5s | 1.7s |
| 后端总耗时 | ~25s | ~23s(不变) |
| 前端误判超时 | ✅ 必发 | ❌ 不再发生 |
| 用户看到的 | 干等 24s → 突然出文字 | 立刻看到思考链 → 答案逐字流出 |
后端跑 23 秒是物理上限,跑不掉。但感知耗时从 24 秒变成 ~2 秒。
这不是博客 chat 独有的教训。任何后端要跑 ≥ 5 秒的 agent loop,前端都面临同样的取舍:等到底再说话,还是把过程拆成结构化事件流出去。让用户看见,而不是让用户等待。区别只是你愿不愿意把"思考过程"也设计成产品的一部分。
刷新博客首页,问 Polly:"聊聊你最新的博文"。看着那个 ✓ Polly 想了 19 秒 的折叠条出现——这次,等待是看得见的。