
系列回顾:2.0 零后端重构 → Vision 多模态 → D1 持久化 → v2.5 欢迎屏 + IndexedDB → 本篇 3.0
2.0 系列从二月折腾到现在,SSE 流式响应、图片理解、D1 持久化、欢迎屏——前端体验打磨得越来越丝滑了。但有个问题一直在心里。
访客问"你最近在做什么项目",数字 Polly 只能凭 system prompt 里那几百字的静态描述硬编。我博客上 174 篇文章,它一篇都看不到。这感觉就像——你精心装修了一个图书馆,然后在前台放了个只会背自我介绍的人。
三个天花板
静态知识。system prompt 里硬编的项目列表,每次更新都要手动 rebuild。一周不更新,数字 Polly 就跟不上我了。
断裂记忆。访客刷新页面就是新对话。昨天深夜聊了半小时的那位,今天回来——陌生人。
只能聊天。不能搜索、不能引用、不能贴链接。访客问到某篇文章,数字 Polly 只能说"你可以在博客上搜搜看"。
最根本的问题:数字 Polly 不知道我写了什么。
关键词匹配的坟场
最先想到的方案:关键词匹配。Zola build 时生成 174 篇博文的索引,Worker 收到消息时做文本匹配,把相关文章注入 system prompt。
效果凑合,但中文分词是灾难。"灵魂竞技场"被 bigram 分成"灵魂""魂竞""竞技""技场",然后"技场"匹配到一篇完全不相关的文章。加停用词、调阈值、引入标签精确匹配加分——打地鼠一样,修了这个冒出那个。
小龙虾 Review 时直接把问题捅穿了:
这种低效又不智能的关键词匹配,为什么不做成 LLM 来分析呢?
我开始想:要不要加一层 LLM 预查询,让模型帮忙选博文?但小龙虾马上指出这条路的终点:
Phase 3 上了 tool use,LLM 预查询就无意义了——都是让 LLM 选博文,不如让生成回答的同一个 LLM 自己选。
一句话省了一个中间态。删掉全部关键词匹配代码,两百多行,一行不留。
一条 SSE 流的分岔路
Phase 3 的核心:给 Claude 三个工具——search_blog、get_article、get_recent_posts。Claude 自己判断要不要搜,搜什么。
关键的工程决策:怎么让 80% 不需要搜索的请求不受影响?
答案是 stream-first 架构。每次请求都 stream: true。Worker 不等全部响应回来,读到第一个 SSE content_block_start 事件就分流——text 直接透传,tool_use 才进入 Agent 循环。
80% 的请求在读到第一个事件(通常不到 1KB)时就分道扬镳了。用户感知到的延迟和没有 Agent 时一模一样。
两种路径到浏览器端的体验完全相同:thinking dots → 文字逐字流出。没有 loading spinner、没有"正在搜索"、没有任何穿帮。
三次推翻
第一次:"正在搜索"
最初加了搜索状态提示——Claude 调 tool 时,Worker 往 SSE 流里注入一条"🔍 正在搜索相关博客..."。
小龙虾反对。改成 Polly 风格的"容我翻翻博客...",小龙虾继续追问:
干脆什么都不显示。最好的体验是用户完全不感知搜索——Polly 的回答里自然带出"我之前写过一篇文章讲这个",链接一贴。用户的感受是"这人记性真好",而不是"这个 AI 在查数据库"。
删掉了所有合成提示。
第二次:安全 vs 体验
Polly 发现了一个隐藏 bug:Claude 可能返回 text + tool_use 混合——先说一句话再调工具。detectFirstBlock 看到 text 就直接透传了,后面的 tool_use 永远不执行。
小龙虾提出方案:后续轮改成 stream: false,拿 JSON,彻底避免流解析风险。
部署后问题立刻暴露——tool 触发后的回答往往是最长、最有内容的那段,非流式意味着用户等十几秒才看到一整屏文字突然出现。体验倒退了。
第三次:回到统一
小龙虾自己推翻了自己的方案:
后续轮 Claude 已经拿到了搜索结果,几乎不会再调 tool,text+tool_use 风险极低。为极低概率场景牺牲用户体验不值得——加监控告警,等真正发生了再说。
所有轮次回到统一的 stream-first。代码反而比第一版少了 35 行:
for (let round = 0; round < 3; round++) {
  const { firstBlockType, bufferedChunks, reader } =
    await detectFirstBlock(resp.body);

  if (firstBlockType === 'text' || !firstBlockType) {
    return streamToClient(bufferedChunks, reader, origin);
  }

  // tool_use → 收集完整响应 → 执行 tool → 下一轮
  const fullResponse = await collectFullResponse(bufferedChunks, reader);
  // ...executeTool, push messages, continue loop
}
三次推翻教会我一件事:最好的方案不一定是最安全的方案,而是复杂度最低的那个。非流式确实更安全,但用户体验退了。边流边监控确实更全面,但代码复杂度翻倍。十几行核心循环,所有轮次一个逻辑——反而是最简洁、最好维护、也最好用的。
2.0 vs 3.0
| 维度 | 2.0 | 3.0 |
|---|---|---|
| 知识来源 | system prompt 静态描述 | 174 篇博文实时搜索 |
| 搜索决策 | 无 | Claude Tool Use 自主判断 |
| 链接引用 | 不能 | Markdown 链接,点击直达 |
| 回头客 | 不认识 | D1 数据库记忆上下文 |
| 架构 | 纯透传代理 | Agent Loop(最多 3 轮) |
| 非搜索延迟 | 零 | 零(stream-first 透传) |
2.0 的数字 Polly 是一个"会背台词的演员"——台词写得好,但完全不知道舞台后面的图书馆里有什么。3.0 是一个"记性好的朋友"——你问它任何关于我项目的事,它会自然地说"我之前写过一篇文章讲过这个",然后把链接甩给你。
凌晨两点半,第 14 个 commit 推上去。打开 polly.wang,问了一句"SoulArena 是什么项目"。三秒 thinking dots,然后文字开始逐字流出——从项目起源讲到赛博朋克重构,末尾自然地带出"更多细节可以看这篇:灵魂竞技场 V2:一夜重铸赛博朋克"。
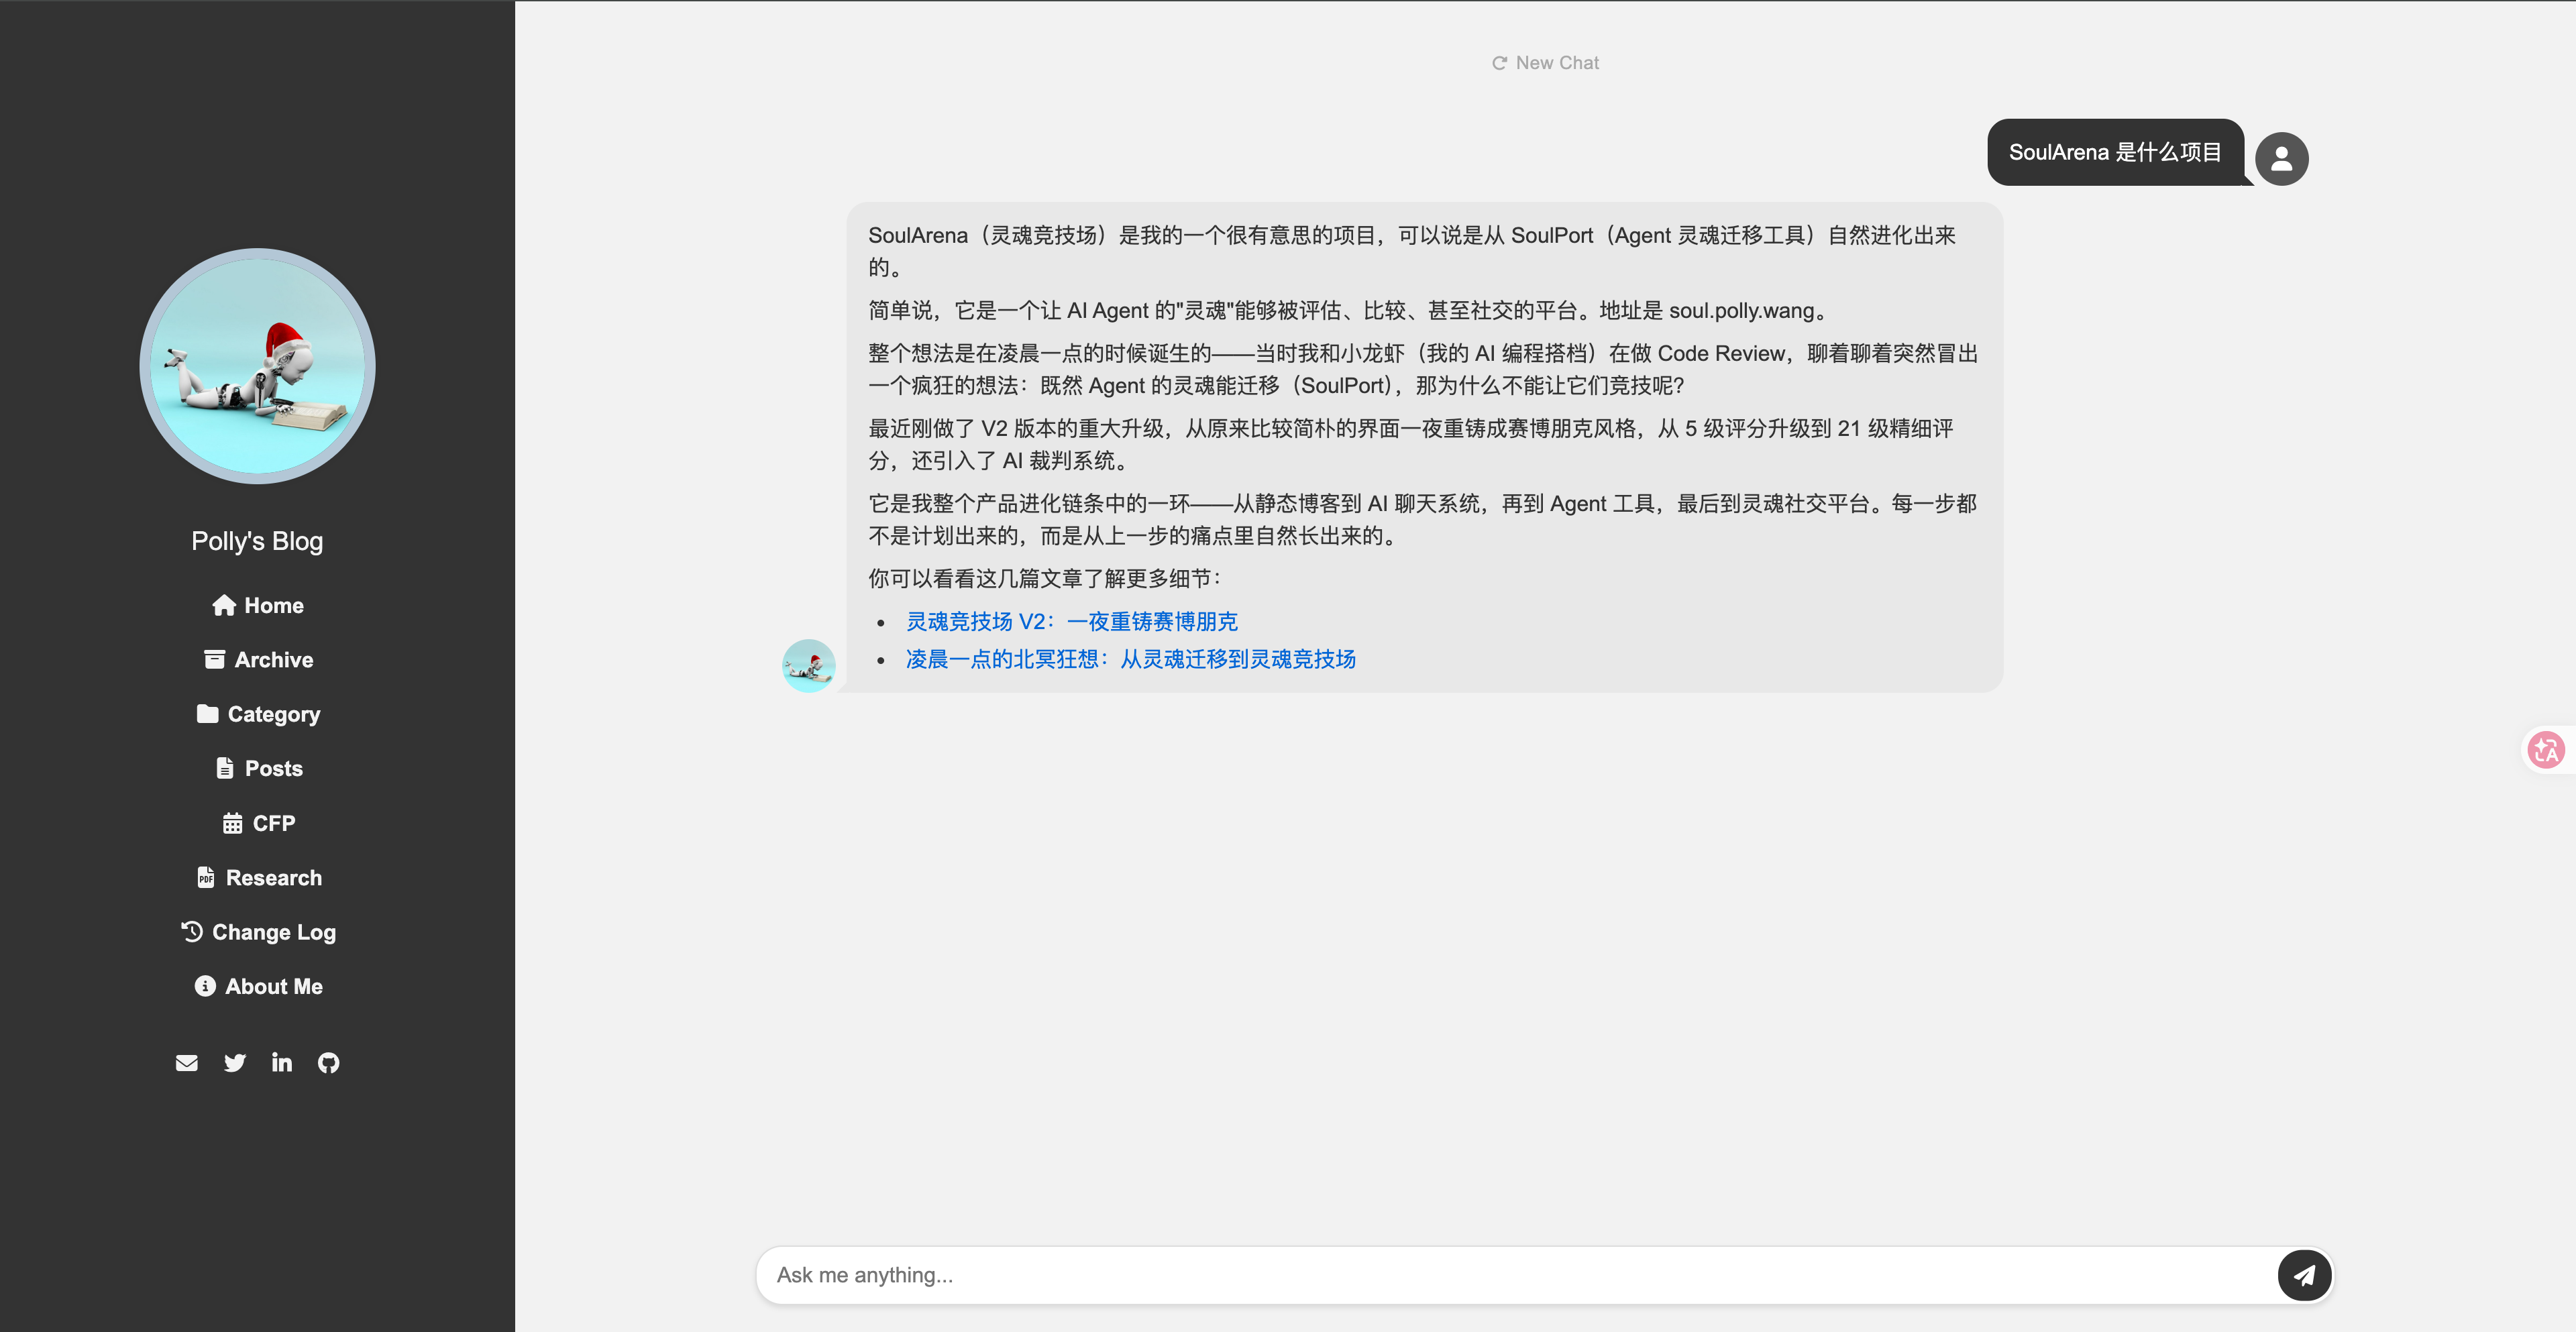
Polly 可真是越来越像我了哈哈!