为 Hackathon 准备 Parking Copilot 的介绍短片时,我接手的 idea 有一个很清楚的技术起点:通过历史停车数据,借助 AI 预测、优化车位使用,提升整体使用率。
但最后做出来的两分钟短片,是从一个女孩的第一辆车讲起的。观看完整短片:Parking Copilot · The Freedom to Arrive(约 2 分钟)
这中间最值得回看的,不只是用了什么工具。换谁来当主角,产品在什么时候出现,哪些画面应该生成、哪些应该用代码做,以及两张各自看着不错的图为什么接不起来——这些选择,才慢慢决定了影片的样子。
我先换了故事的主角
从停车场管理员的角度出发,这个 idea 很自然会被讲成一段效率介绍:有多少车位,怎样预测需求,如何提高使用率。对于关心资源配置的人,这些都很重要。
但这次,我更想让以员工为主的观众产生代入感。镜头如果一直停在管理者的位置,大家能理解系统的能力,却未必觉得它与自己的生活有关。
于是,我把镜头转向了一名毕业不久、靠自己的努力买下第一辆车的职场新人。
这里也要特别感谢 Lexie,为这次短片制作提供了友情帮助与支持。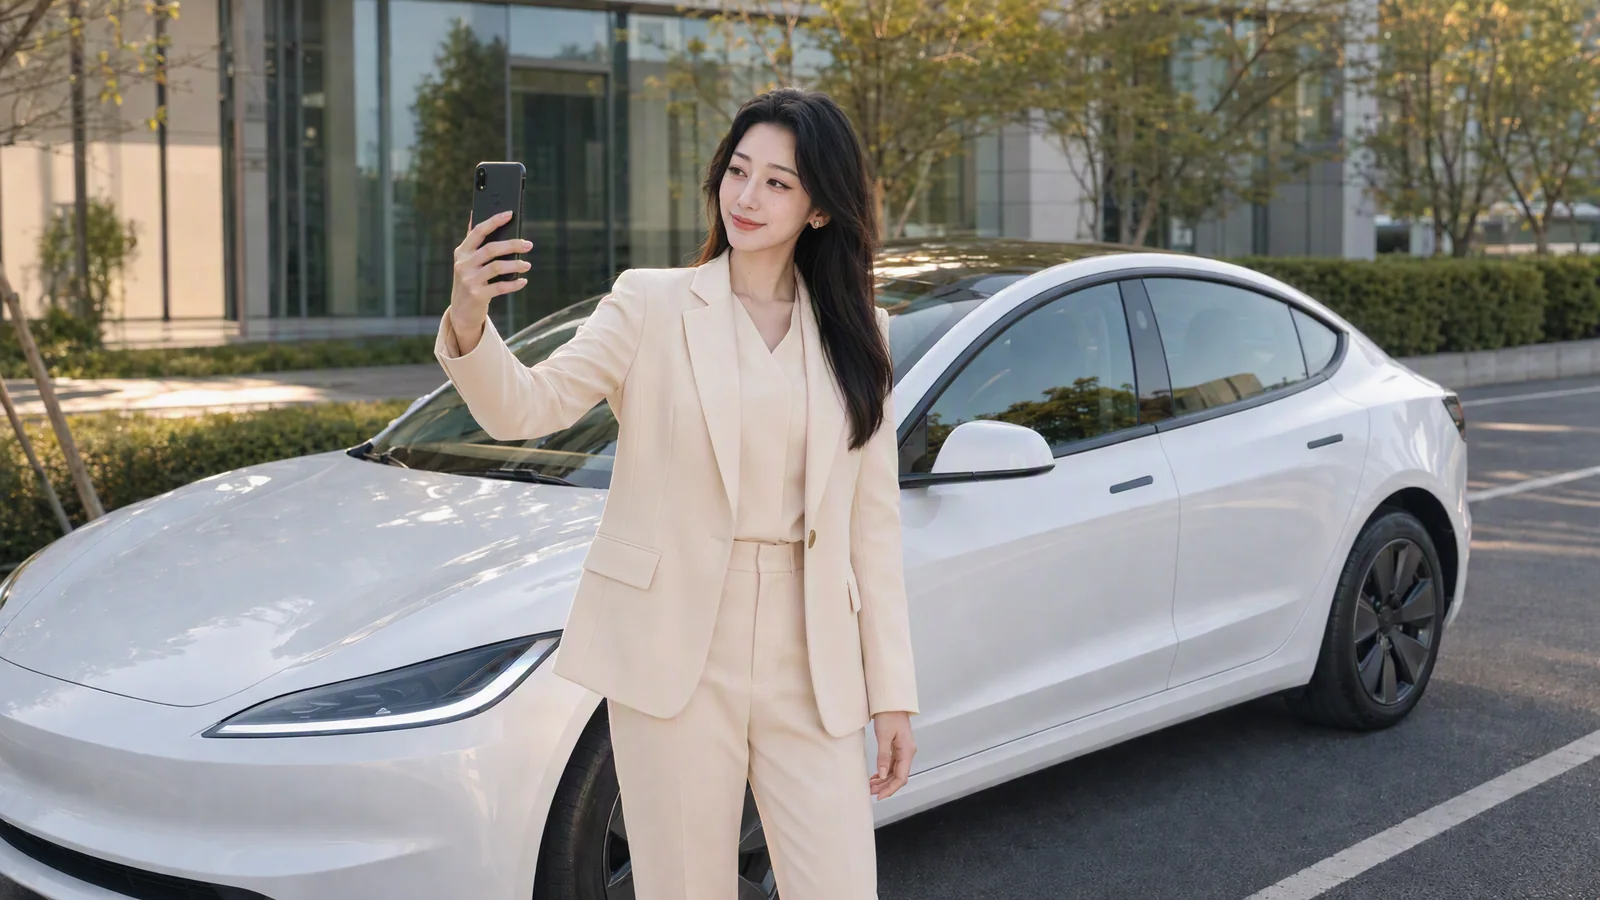
工牌、车钥匙、车边的一张纪念照,先交代她为什么在意这辆车。它是努力换来的新生活,也带着一种很具体的期待:终于可以自己决定什么时候出发、去哪里了。
随后,停车的麻烦才进入故事。申请公司的停车资格,不知道还要等多久;终于进入车库,不知道该往哪里走;想充电,车位被占着;下班了,又得找到自己的车。
等待、停车、充电、找车,原本可以是四个并列的功能模块。放到同一个人的经历里,它们开始共享一种感受:我已经到了这一步,但不知道下一步怎么办。
Parking Copilot 每一次出现,都给她一个可以继续往前走的答案。
这样一来,Freedom 就不只是片尾的一句漂亮话。开头,她以为拥有车就拥有了自由;后面,我们才一点点看见,心里有数、知道方向、能够从容抵达,也是自由的一部分。
先让她遇到问题,再让产品出现
有了人物,并不意味着故事就自动成立。最容易发生的事,是给她安排一个困境,紧接着切出产品界面,开始介绍功能。
我更喜欢剧本里“等待停车资格”的处理。
她提交申请,页面只留下“等待中”。午休时再看,还是那三个字;第二天换了时间、换了桌面上的东西,结果仍然没变。反复打开同一个页面,已经足够说明她的焦虑,不必再让她说一大段抱怨。
接着,Parking Copilot 给出了停车排队名次和预计等待区间。剧本中的演示设定是第 27 名、10–12 周。她没有立刻获得车位,只是终于知道自己可以怎样安排接下来的日程。
这场戏真正的落点,是她收起了手机。
从反复刷新,到可以去做别的事,帮助才落到了一个看得见的动作上。
旁白也因此不必重复屏幕上的数字,而是补上画面背后的感受:
The hardest part wasn't waiting. It was not knowing how long.
最难熬的不是等待,而是不知道还要等多久。
这是剧本中的设计,不是对最终成片逐镜逐秒的复述。到了制作阶段,连续动作还要拆成能够完成的镜头:一张静帧不能同时表达打开页面、刷新和收起手机。
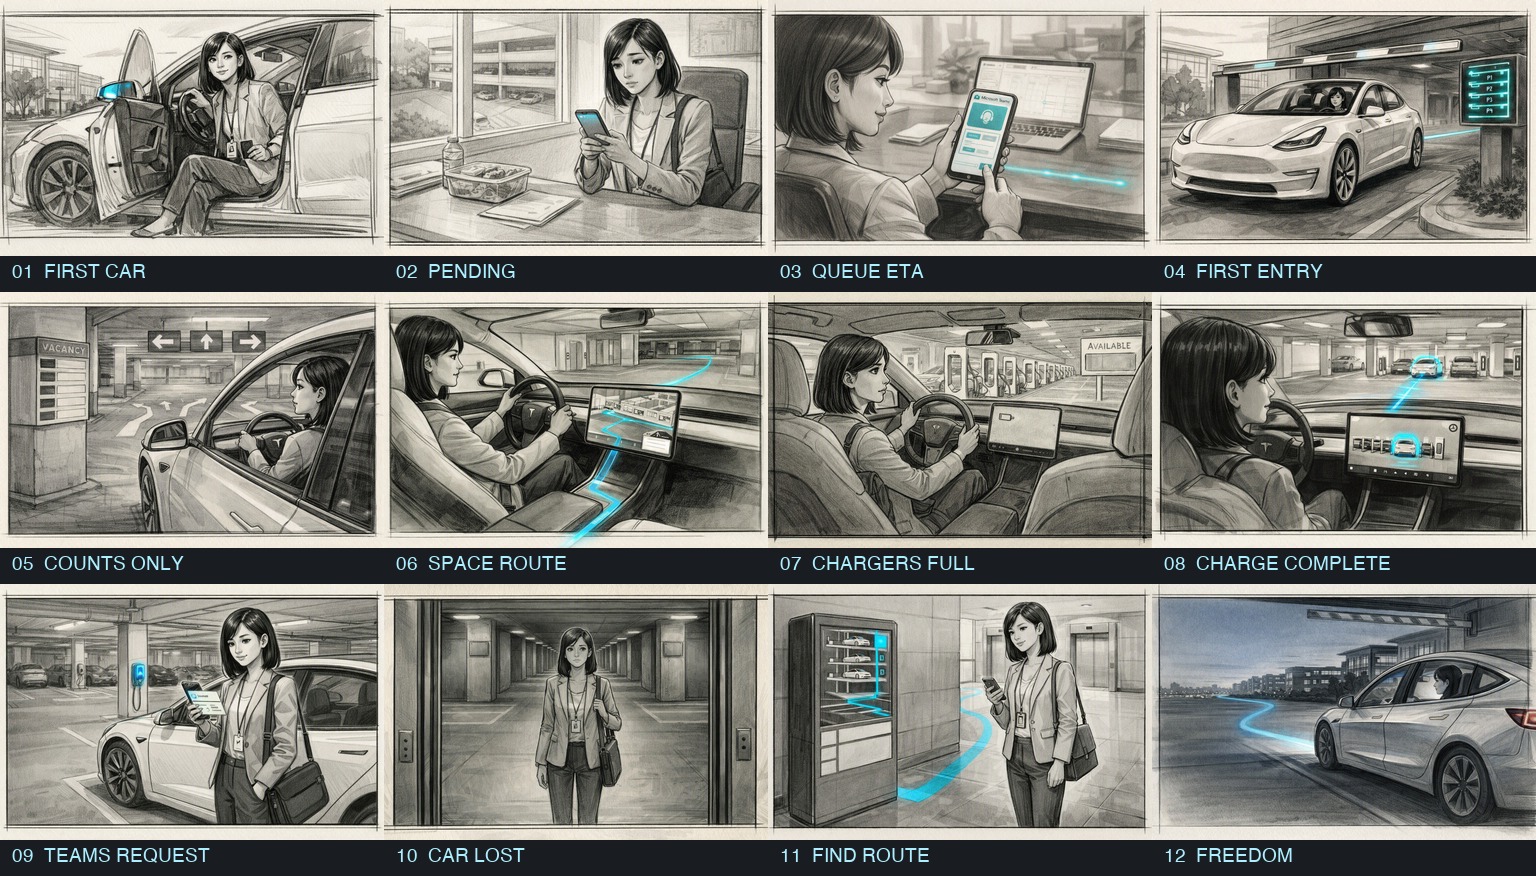
分镜在这里帮我把“想表达什么”,变成“观众这一眼需要看到什么”。先看到目的地,再看到导航启动;先知道该停在哪里,再确认已经停好。每个镜头承担一点信息,相邻镜头才有接下去的理由。
如果重新开始一个类似项目,我仍会先写清人物遇到的一件事,以及得到帮助后会有什么变化,再考虑用什么工具做画面。
有些画面要生成,有些画面要运行起来
这支片子的制作,主要靠 AI 生成静帧、代码制作的界面视频,以及剪辑合成协作完成。
人物、光线和环境氛围,适合交给 gpt-image-2。先建立角色参考,再给出场景与镜头要求,逐张检查结果。参考图也要分工:人物参考帮助保持身份,车型参考约束车辆外观,空间参考交代位置关系。放进同一张脸,不代表其他细节就都会稳定下来。
但停车排队名次、等待区间、车位编号和导航路线,需要更准确的控制。这些部分由 React、TypeScript 和 Three.js 承担。Demo 因而不只是展示产品的网页,也成为影片的一种素材来源。
第一幕里有一个很短的镜头:车机屏幕显示去公司的目的地,随后启动导航。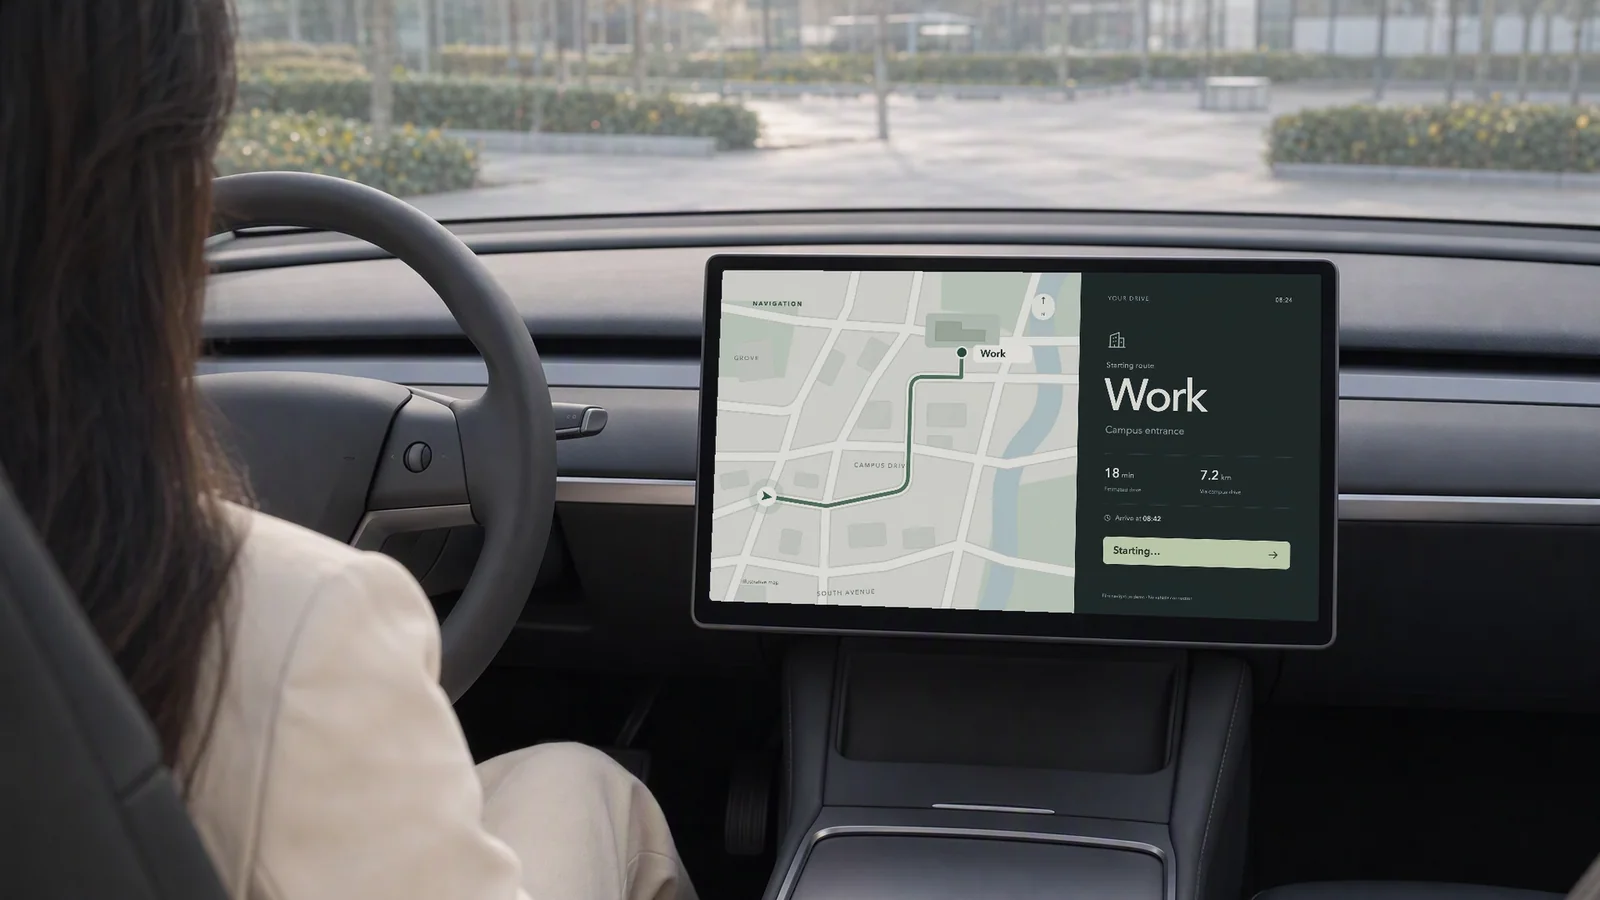
制作时,界面实际运行,再按固定时刻采样,把每一帧按透视映射进车内底图的屏幕区域。这样,人物和车内环境可以保留,而按钮、文字与导航状态按需要变化。
这套分工让我能分别判断两类问题:人物神情是否自然,界面信息是否准确。需要改一个数字时,不必重新生成整张人车画面。
这里的界面是为叙事制作的可运行 Demo,并非实时接入企业停车系统;名次、预计时间、车位与路线包含演示设定,不是实际服务承诺。
不过,素材做出来,还只是走到一半。
进入剪映前,每幕都有对应的素材包、清单和操作指南。第一次装配,先把镜头排通,再给合适的静帧加轻推,最后接上声音。后来某个画面返工,则替换相应素材,检查原来的节奏和声音还能不能对上。
静帧不需要独自承担完整的动作。前一个镜头建立期待,界面变化给出信息,下一个镜头呈现结果;旁白、点击声、环境声和音乐把它们接起来。轻推可以让画面有呼吸,但屏幕上的字仍要留够时间读。
我也不想让旁白填满每一秒。人物说完了,观众还需要一点时间看界面、辨认空间,或者只是跟着音乐往前走。
两张好看的图,为什么接不起来
车库的返工,让“做出画面”和“做成影片”的区别变得特别具体。
最初发现的问题甚至不是技术瑕疵,而是故事不太对:我们在讲停车的不确定,画面里的车库却空空荡荡。环境越干净,人物的困难反而越难成立。
于是先给相关镜头补入停放的车辆。接下来,问题开始变得琐碎:柱子和车身穿插,邻车款式变了,车头朝向不对;修完这里,轮挡、比例或纹理又出了问题。
单张看,每次似乎都向前走了一点。但把“找到目标车位”和“已经停妥”两个镜头放在一起,情况就不一样了。
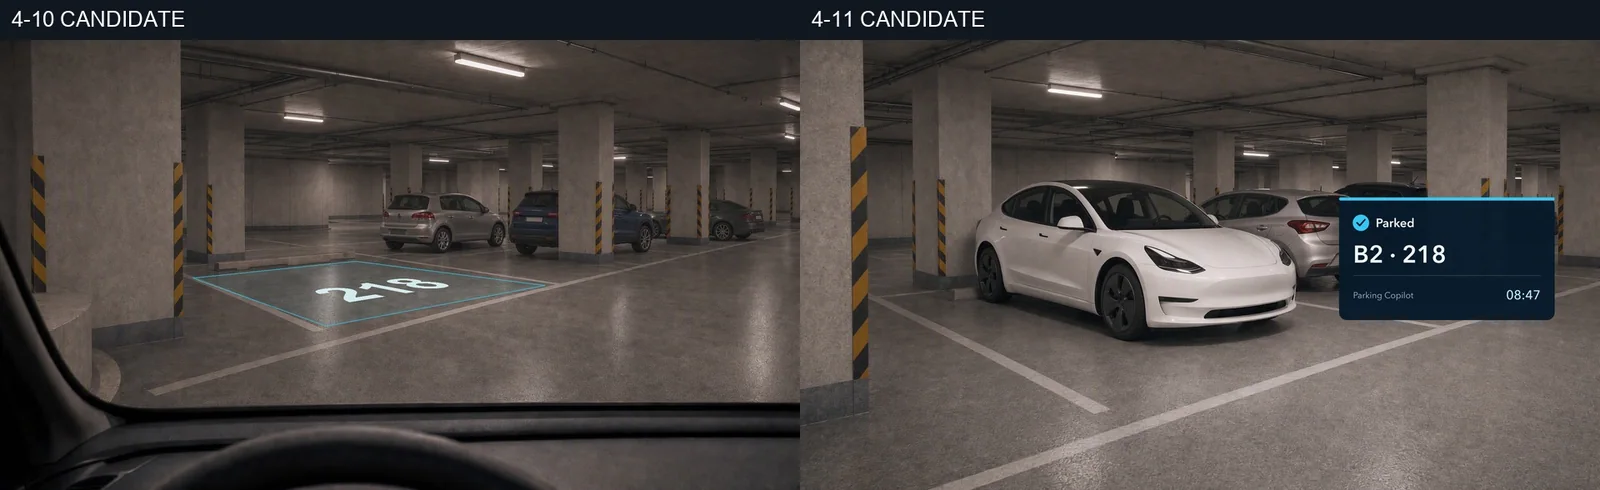
镜头换了,旁边的车与柱子却无法自然对应。观众未必说得出哪里错了,却会感觉她停进了另一个地方。
继续沿着这些候选往下补,越来越像在同时维护两套彼此矛盾的空间。我需要先回答一个更基础的问题:这两个机位,究竟在看同一个怎样的停车区?
后来,我停止了这条补丁链。用 Three.js 先建立同一组三格车位,固定尺度、邻车和轮挡的位置,再分别给出停车前与停车后的机位参考。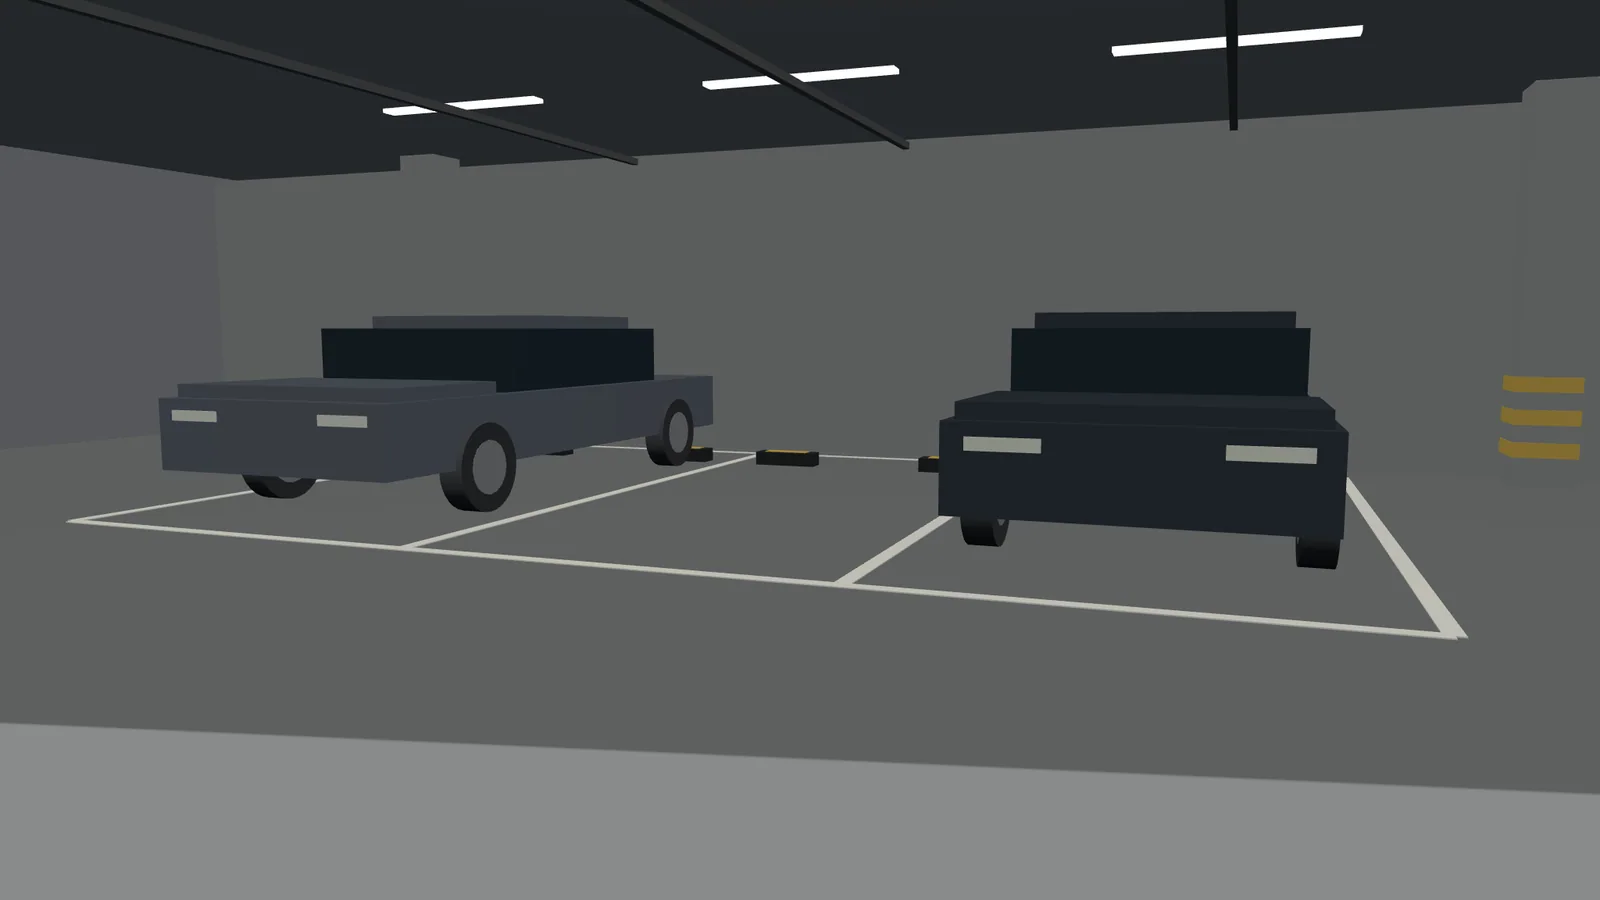
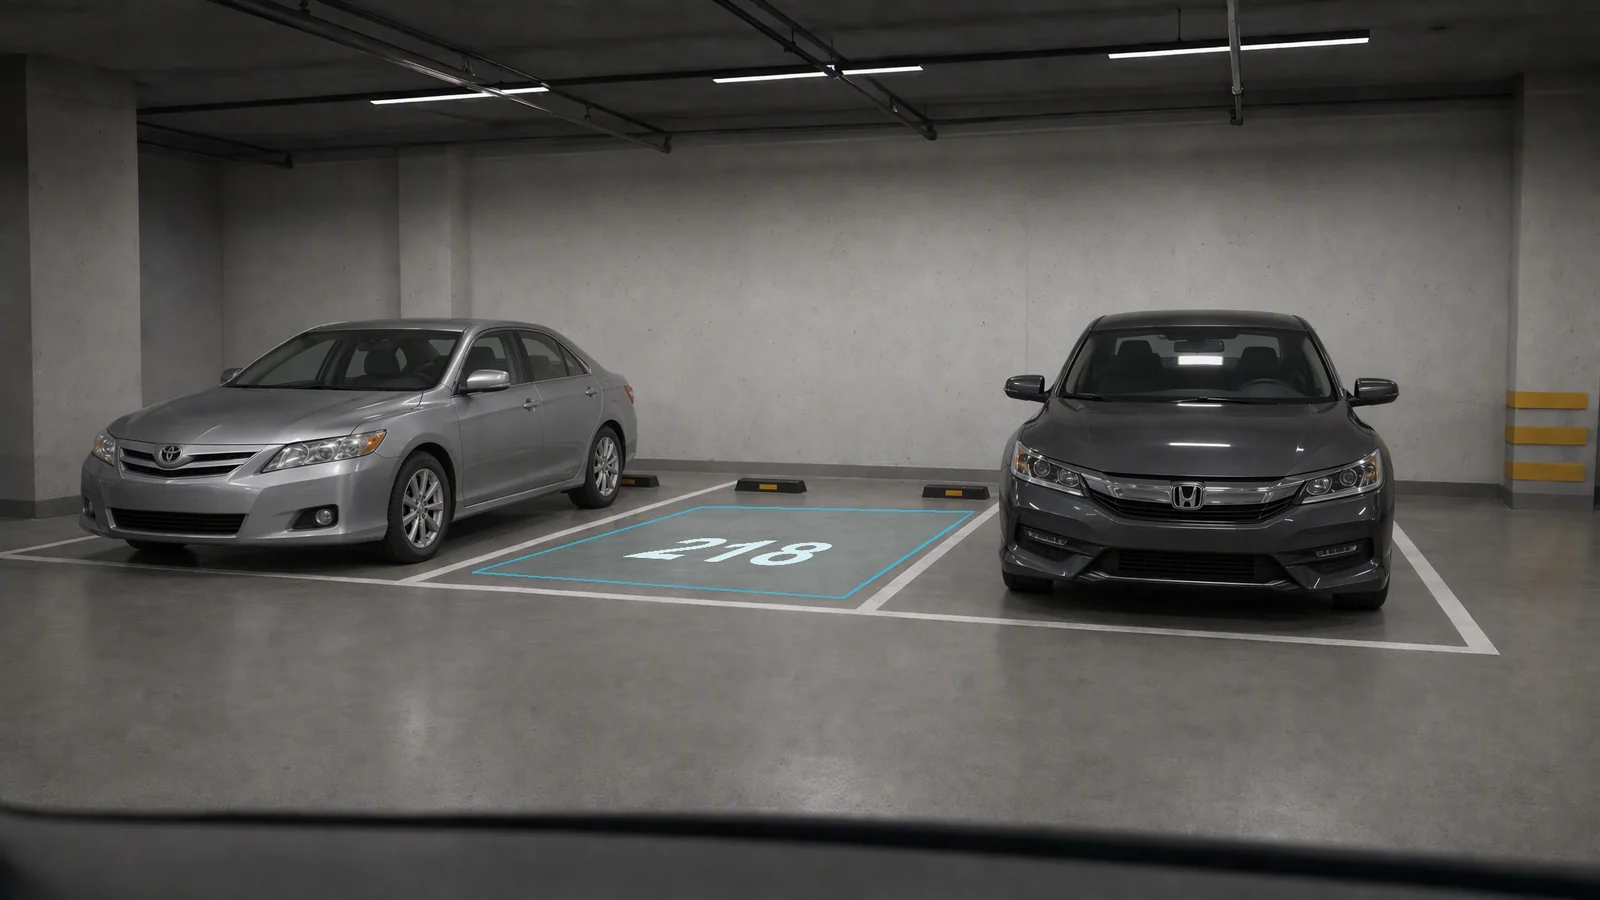
共同布局改善了几何关系,却也没有一键解决所有问题。两次生成仍可能换掉邻车款式,所以还要补充车型对照;车位编号、高亮框与停车确认卡,则单独合成。
这次返工改变了我的检查顺序。先看人物经历能不能成立,再看相邻镜头是否连贯,最后才是局部细节。否则,一张越修越精致的图,也可能在把故事带往错误的方向。
最后,回到那一点点自由
回看这次制作,AI 扩大了我能做出的画面范围,代码提供了精确控制,剪辑让不同素材进入同一段时间。但哪些东西值得留下,仍要回到最初的那个问题:它有没有让观众更理解这个人的处境?
这个问题也帮我处理片尾。等待、停车、充电、找车再次汇合时,它们已经不只是四个功能名称,而是她一路得到过的四次帮助。
具体剧本、分镜和操作细节,我放在了制作流程笔记里;想跟着画面对照这些选择,也可以看完整 Slide。
片尾留下了一句很轻的话:
One less worry. A little more freedom.
少一件需要操心的事,多一点能够自己安排的余地。
起点仍然是那个关于停车数据与使用率的 idea。但当镜头落到一个人身上,我终于有了更具体的方式,去讲它为什么值得被做出来。
The Freedom to Arrive.