
CopilotX 上线三个月了。
从 v2.3.0 的 tools 支持,到 v2.3.3 的流式修复,再到上周那个 藏着三个 bug 的 400——它转发了多少请求?烧了多少 token?帮我省了多少钱?
我一个数字都说不出来。
这就像开了三个月的出租车,不知道跑了多少公里,不知道油耗,不知道收入。仪表盘是黑的,全凭感觉飞。
今晚,给它装眼睛。
凌晨三点半的架构
想法很简单:一个嵌入式 dashboard,不加依赖,不建前端项目,全部塞进一个 Python 文件里。
架构三件套:
- MetricsMiddleware — FastAPI 中间件,拦截所有
/v1/*请求,记录时间、状态码、client IP - MetricsStore — SQLite + WAL 模式,线程安全,内置 API 价格表估算成本
- routes_dashboard — 一个 538 行的 HTML 文件,嵌在 Python 字符串里(是的,就这么粗暴)
为什么不用前端框架?因为 CopilotX 的哲学是零外部依赖。它是个代理,不是个 web 应用。Dashboard 只是个附赠品——打开浏览器就能看,不需要 npm install 任何东西。
唯一的外部引用是 Chart.js 的 CDN 和 Google Fonts。
45 分钟,7 个 commit
03:38  feat: add metrics dashboard with auth (v2.4.0)    +747
03:45  fix: address code review P0/P1 issues              +132 -15
03:48  fix: Anthropic streaming token tracking             +13 -2
03:54  fix: SSE parsing for multi-line Anthropic chunks    +12 -7
03:59  fix: record true stream duration instead of 2ms     +31 -17
04:08  design: completely redesign dashboard UI            +337 -174
04:21  fix: security hardening + dashboard polish          +43 -11
第一个 commit 是 Polly(数字分身)写的初版——功能完整,但界面像个 90 年代的管理后台。我看了一眼,说"重新设计"。于是有了 04:08 那个 337 行的 UI 重写。
中间四个 fix 才是有意思的部分。
流式请求的度量陷阱
CopilotX 的核心场景是流式转发:客户端发请求,CopilotX 拿到后端的 SSE 流,逐块转发。问题来了——中间件在 response 返回时就记录了 latency,但此时流还没开始传。
# 中间件记录的 latency:请求到第一个响应头的时间
latency_ms = round((time.time() - start) * 1000, 2)
结果所有流式请求的延迟都是 2ms。这不是延迟,这是"我刚拿起电话"的时间。
修法是在流式 wrapper 里记录真正的流结束时间,完成后回填:
# streaming.py — 流结束后更新真实耗时和 token 数
if hasattr(request.state, "metrics_row_id"):
    store.update_tokens(
        row_id=request.state.metrics_row_id,
        input_tokens=token_count.input,
        output_tokens=token_count.output,
        latency_ms=round((time.time() - start) * 1000, 2),
    )
另一个坑:Anthropic 的 SSE 格式。标准 SSE 是一行一个 data:,但 Anthropic 偶尔会发多行 chunk。原来的 parser 按行分割后直接 json.loads(),遇到多行 chunk 就炸了。
这些都是"看起来能跑,跑起来数据是错的"问题。Dashboard 不上线,永远发现不了。
小龙虾说:眼睛漏光了
04:08 UI 重写完,我把截图丢给小龙虾做 Review。它一眼看出三个问题:
/health端点暴露了authenticated字段——安全隐患- 401 请求也被记录进 metrics——测试数据污染真实统计
- Nginx 还在广播版本号
第二个最狠。我之前调试的时候发了一堆 401 请求,全被忠实地记进了数据库。Dashboard 上显示的请求里,有一半是我自己的测试垃圾。
就像装了一面镜子,结果镜子里有一半是灰尘。
修复很直接——middleware 里加一行,401 直接跳过不记录;/health 砍掉敏感字段;再加一个 DELETE /dashboard/api/data 让管理员随时清档。Nginx 加了 server_tokens off,十秒的事。
眼睛还脸盲
安全修完了,我看着 Dashboard 的 CLIENT 列,发现了一个新问题:全是 127.0.0.1。
VM 上跑着四个服务——TideWatch、SoulArena、Stylist、还有 CopilotX 自己。它们都通过 localhost 调 CopilotX,所以 IP 全一样。眼睛是睁开了,但它分不清谁是谁。
小龙虾建议了一个三层身份模型:
| 维度 | 字段 | 来源 | 用途 |
|---|---|---|---|
| 网络层 | client_ip | TCP 连接 | IP 定位 |
| 应用层 | client_id | X-Client-Id header | 服务区分 |
| 用户层 | user_id | 未来 API Key 映射 | 多用户(Phase 2/3) |
改动很小:middleware 读一行 header,store 加一列,Dashboard 优先显示 client_id,没有的话 fallback 到 IP。各服务端加一行:
default_headers = {"X-Client-Id": "tidewatch"}
有 header 的请求,CLIENT 列青色显示服务名;没有的,灰色显示 IP。脸盲治好了。
916 行的全貌
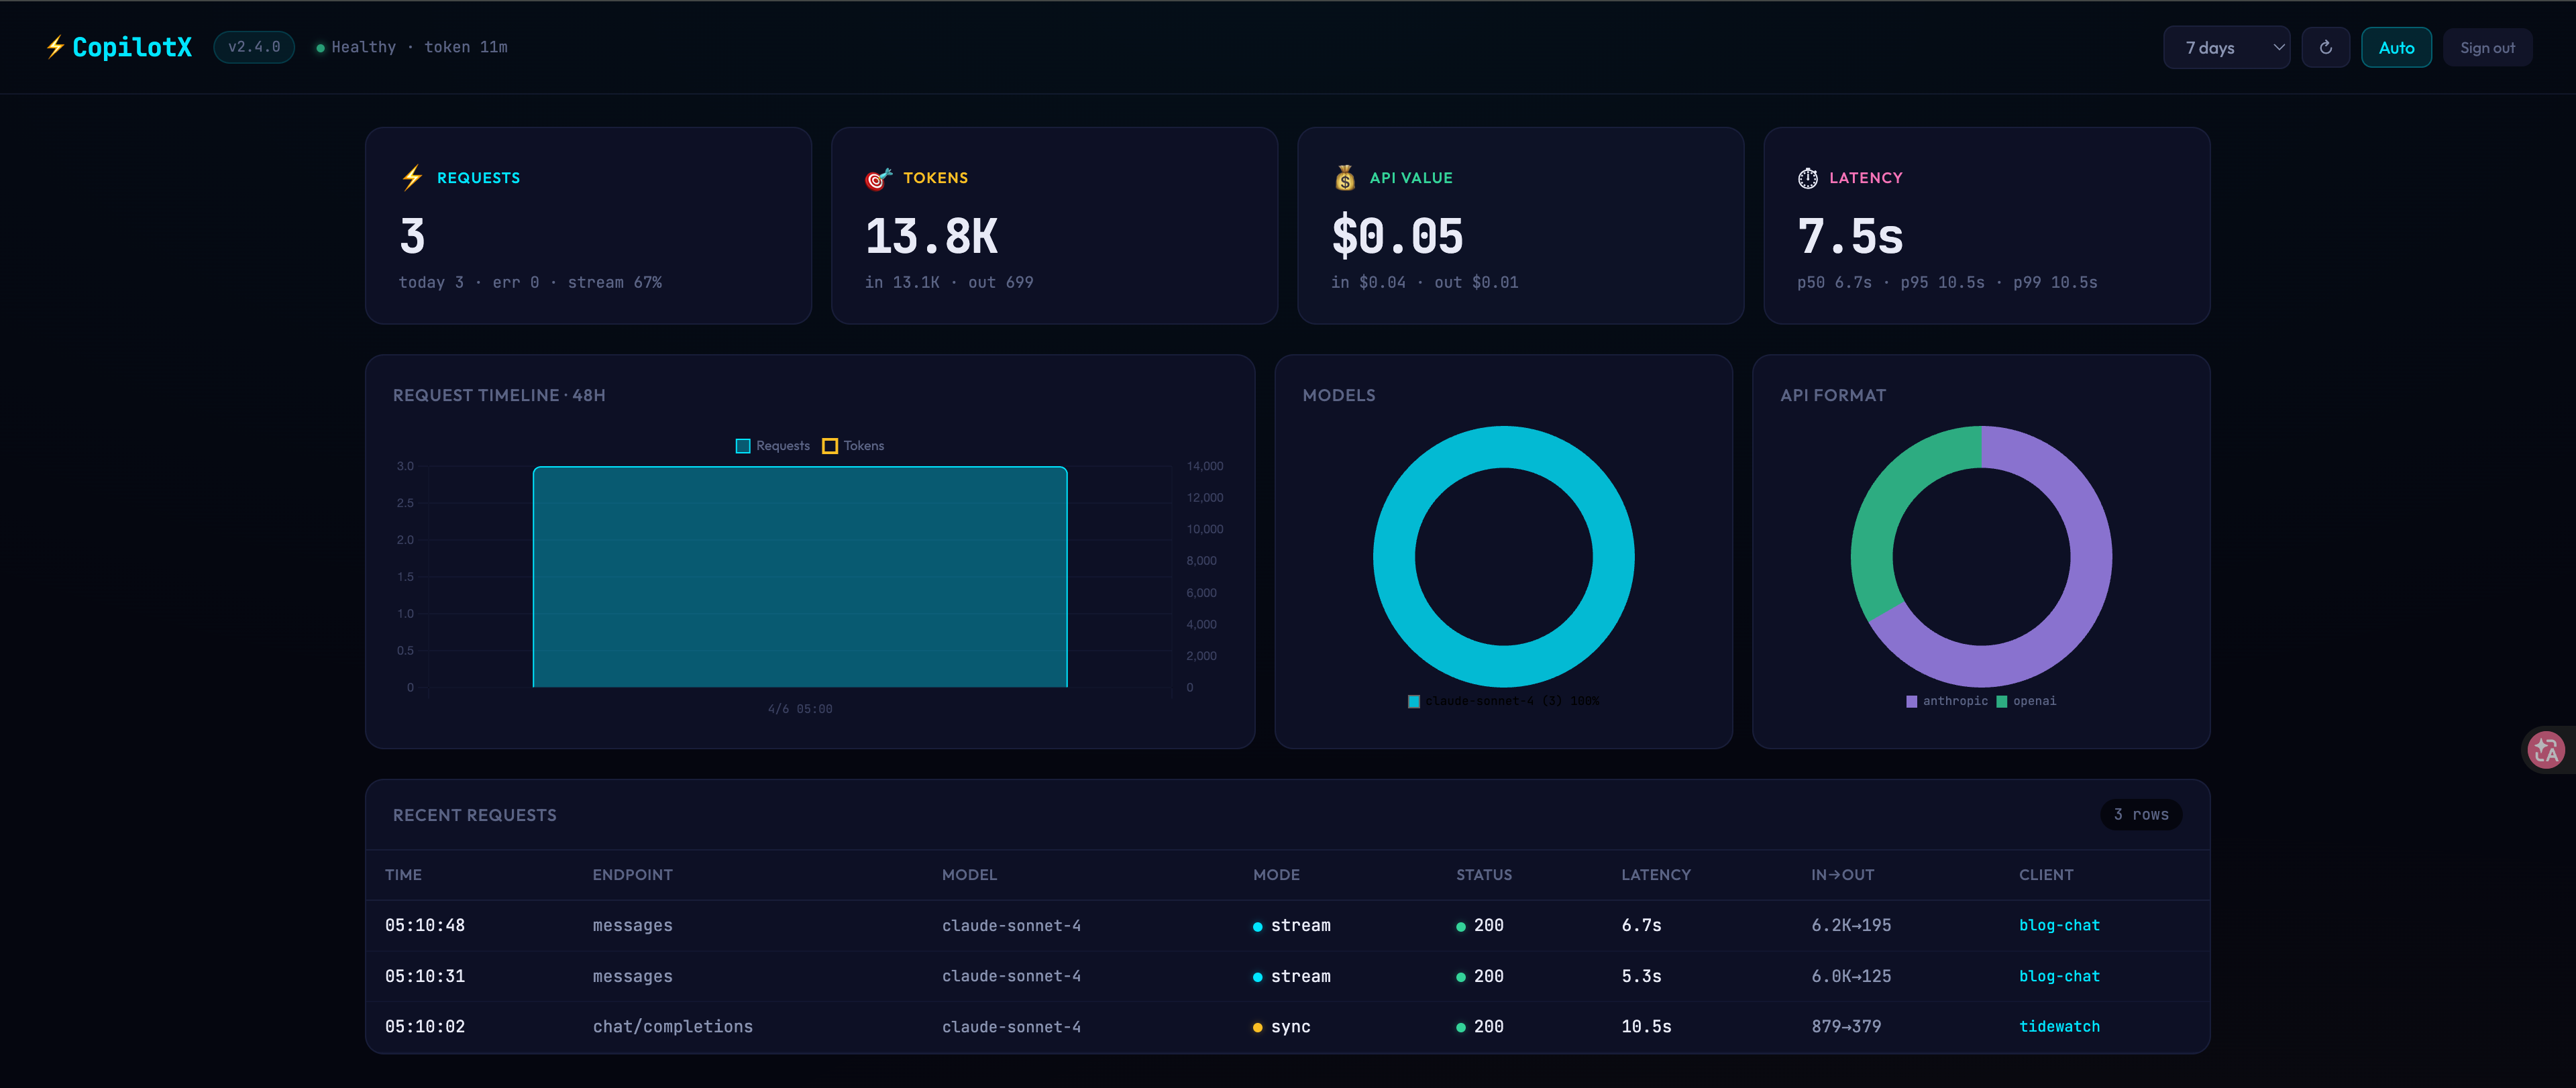
全部嵌在一个 Python 文件里。SQLite WAL 模式,线程安全,零外部依赖。打开浏览器就能看到:48 小时请求时间线、按官方定价估算的成本、真实的端到端延迟分布、模型调用比例,还有每条请求的完整明细——从 token 数到 Client 身份。
暗色主题,霓虹色点缀。看起来像个正经的 DevOps 监控面板,其实只是个 Python 字符串。
盲飞结束
三个月前 CopilotX 上线的时候,我只关心"能不能用"。v2.3 解决了 tools,v2.3.3 解决了流式,v2.4 解决了"你到底干了什么"。
从功能到稳定到可观测——这大概就是一个工具成熟的三步曲。而可观测性本身也走了三步:先能看(Dashboard),再看准(401 过滤 + 流式真实耗时),最后看清谁是谁(X-Client-Id)。
下次有人问我"CopilotX 省了多少钱",我终于不用说"大概"了。打开 Dashboard,数字就在那里。
系列回顾
| 版本 | 日期 | 文章 |
|---|---|---|
| v2.0 | 02/09 | CopilotX:把 Copilot 变成本地 API |
| v2.1 | 02/09 | CopilotX v2.1:从本机到云端 |
| v2.3.0 | 02/13 | v2.3.0:终于能用 tools 了 |
| v2.3.2 | 02/18 | v2.3.2:当 400 变成了「你猜怎么了」 |
| v2.3.3 | 02/20 | v2.3.3:一个空行引发的「血案」 |
| v2.4.0 | 03/28 | 一个 400 背后藏着三个 Bug |
| v2.4.0 | 04/06 | 盲飞三个月后,它终于睁开了眼(本文) |